本文摘自:Anthropic · The components of agent memory
Anthropic 提出新的四层 Memory 架构:Agent 如何通过 Dreaming 变得更聪明?
丹麦哲学家Soren Kierkegaard曾写道:“人生只能向后理解,但生活必须向前”。Anthropic为 AI Agent设计记忆系统时,也遇到了类似的困境。
作为人类,我们在日常生活中不断编码记忆。大脑中的海马体扮演着核心角色——它能实时捕捉当下经历,让记忆快速形成并能被即刻调取。但并非所有经历都能留下来,只有一部分会被巩固转化为长期知识。
这种巩固大部分发生在我们的大脑处于“离线”状态时。在睡眠和休息期间,海马体会默默“重播”最近的经历,逐步提炼这些体验,并将其整合融入新皮质——即储存我们绝大部分知识与认知的区域。
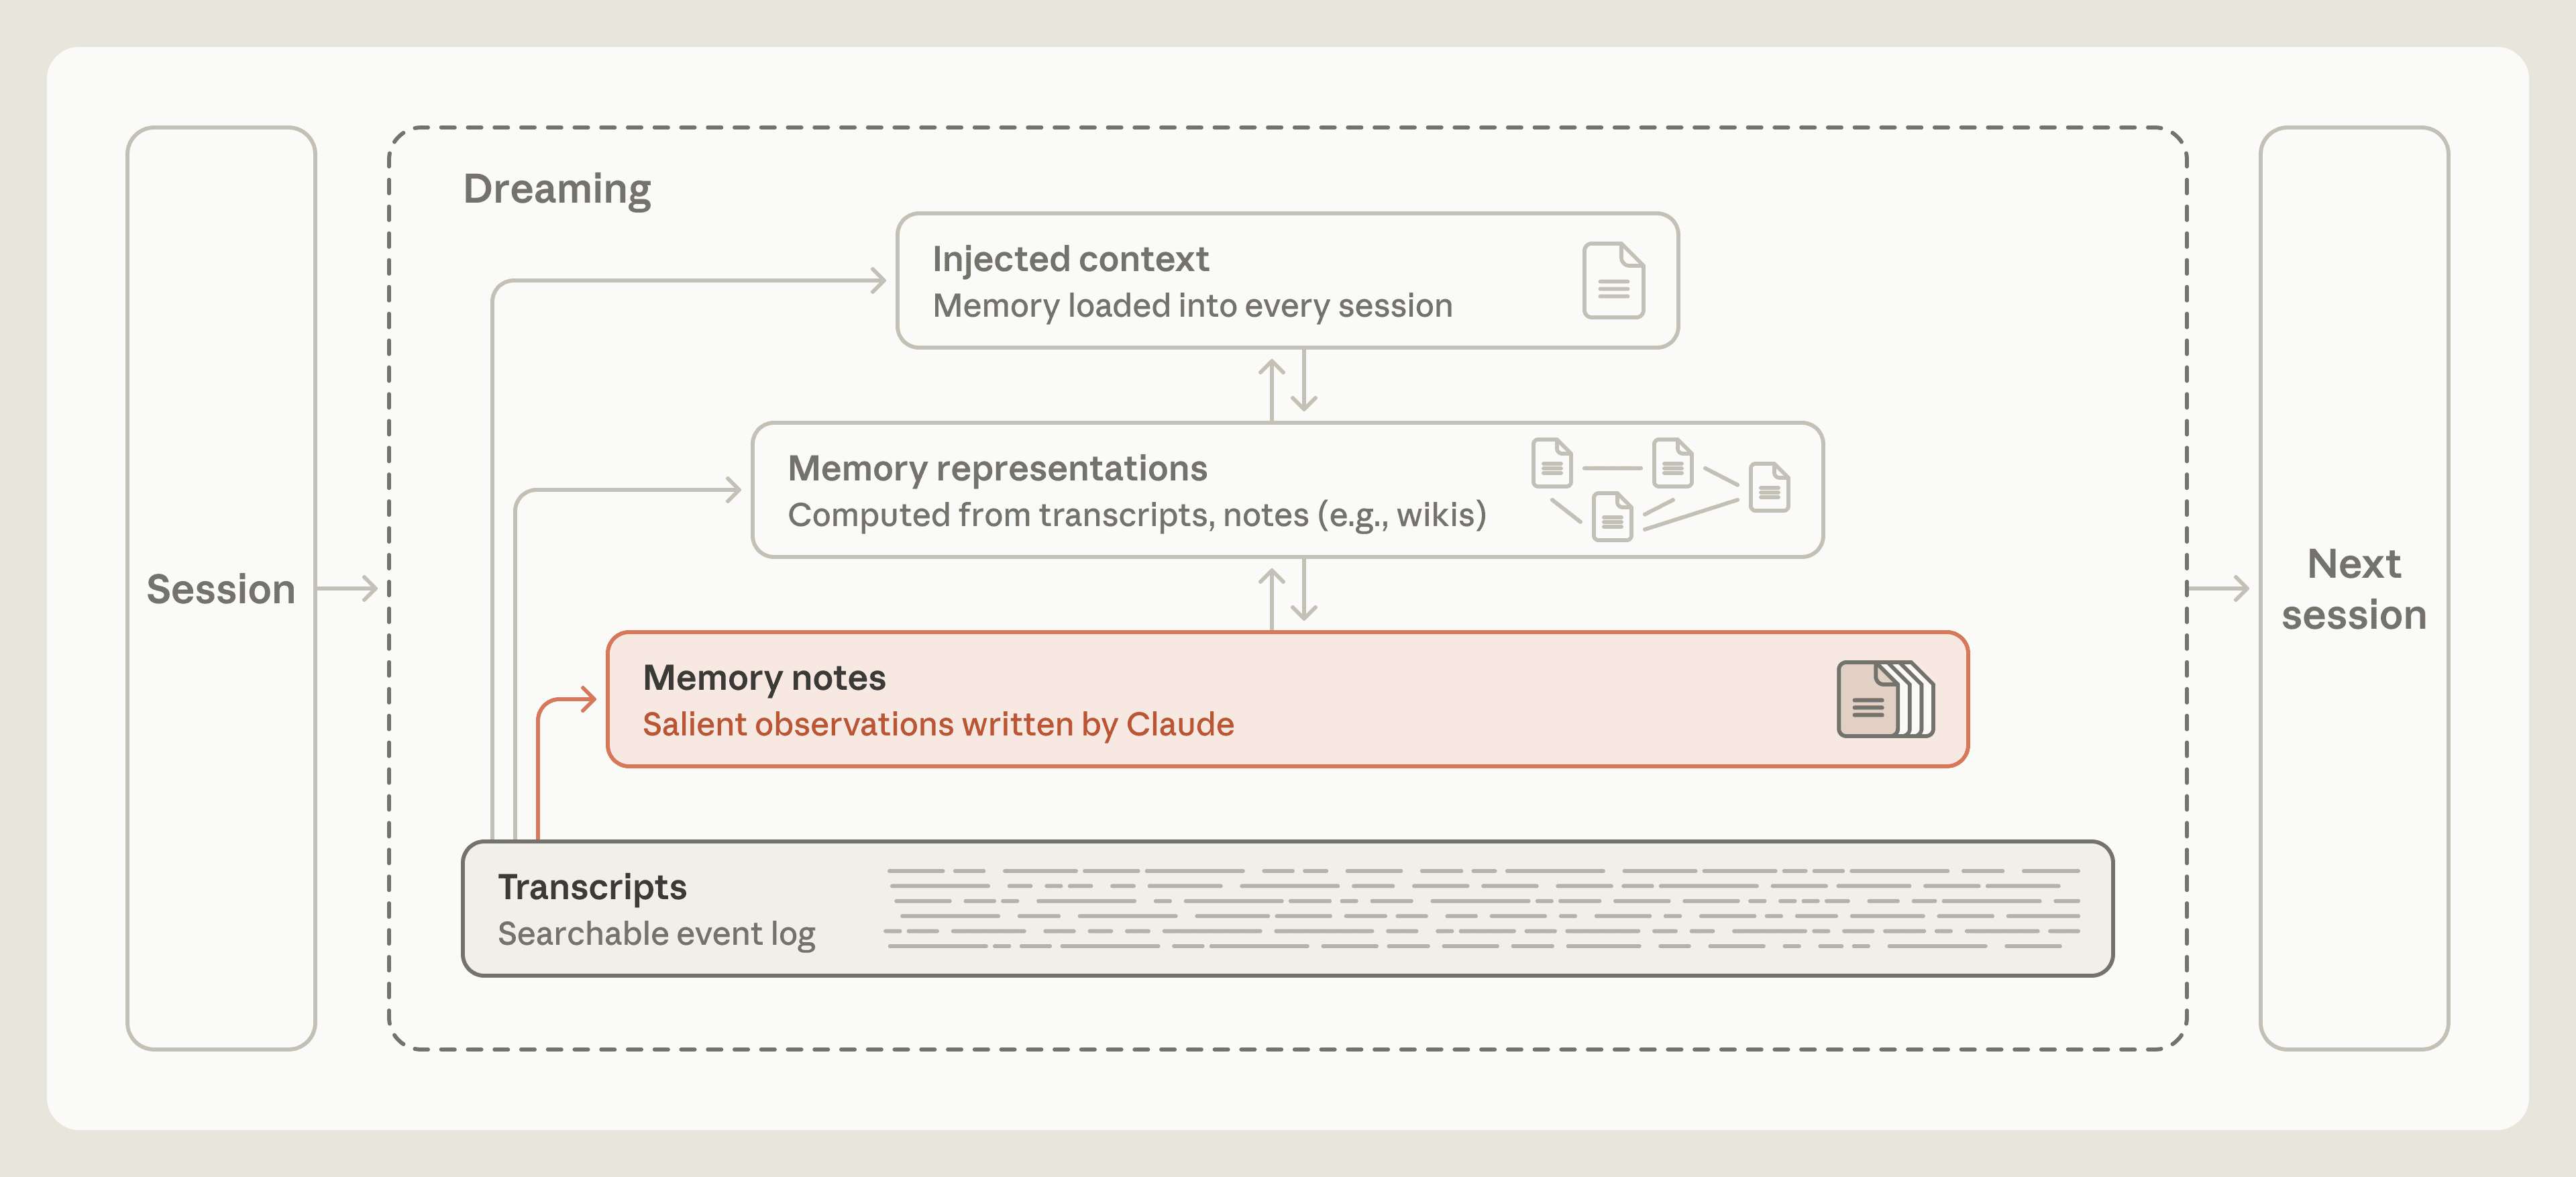
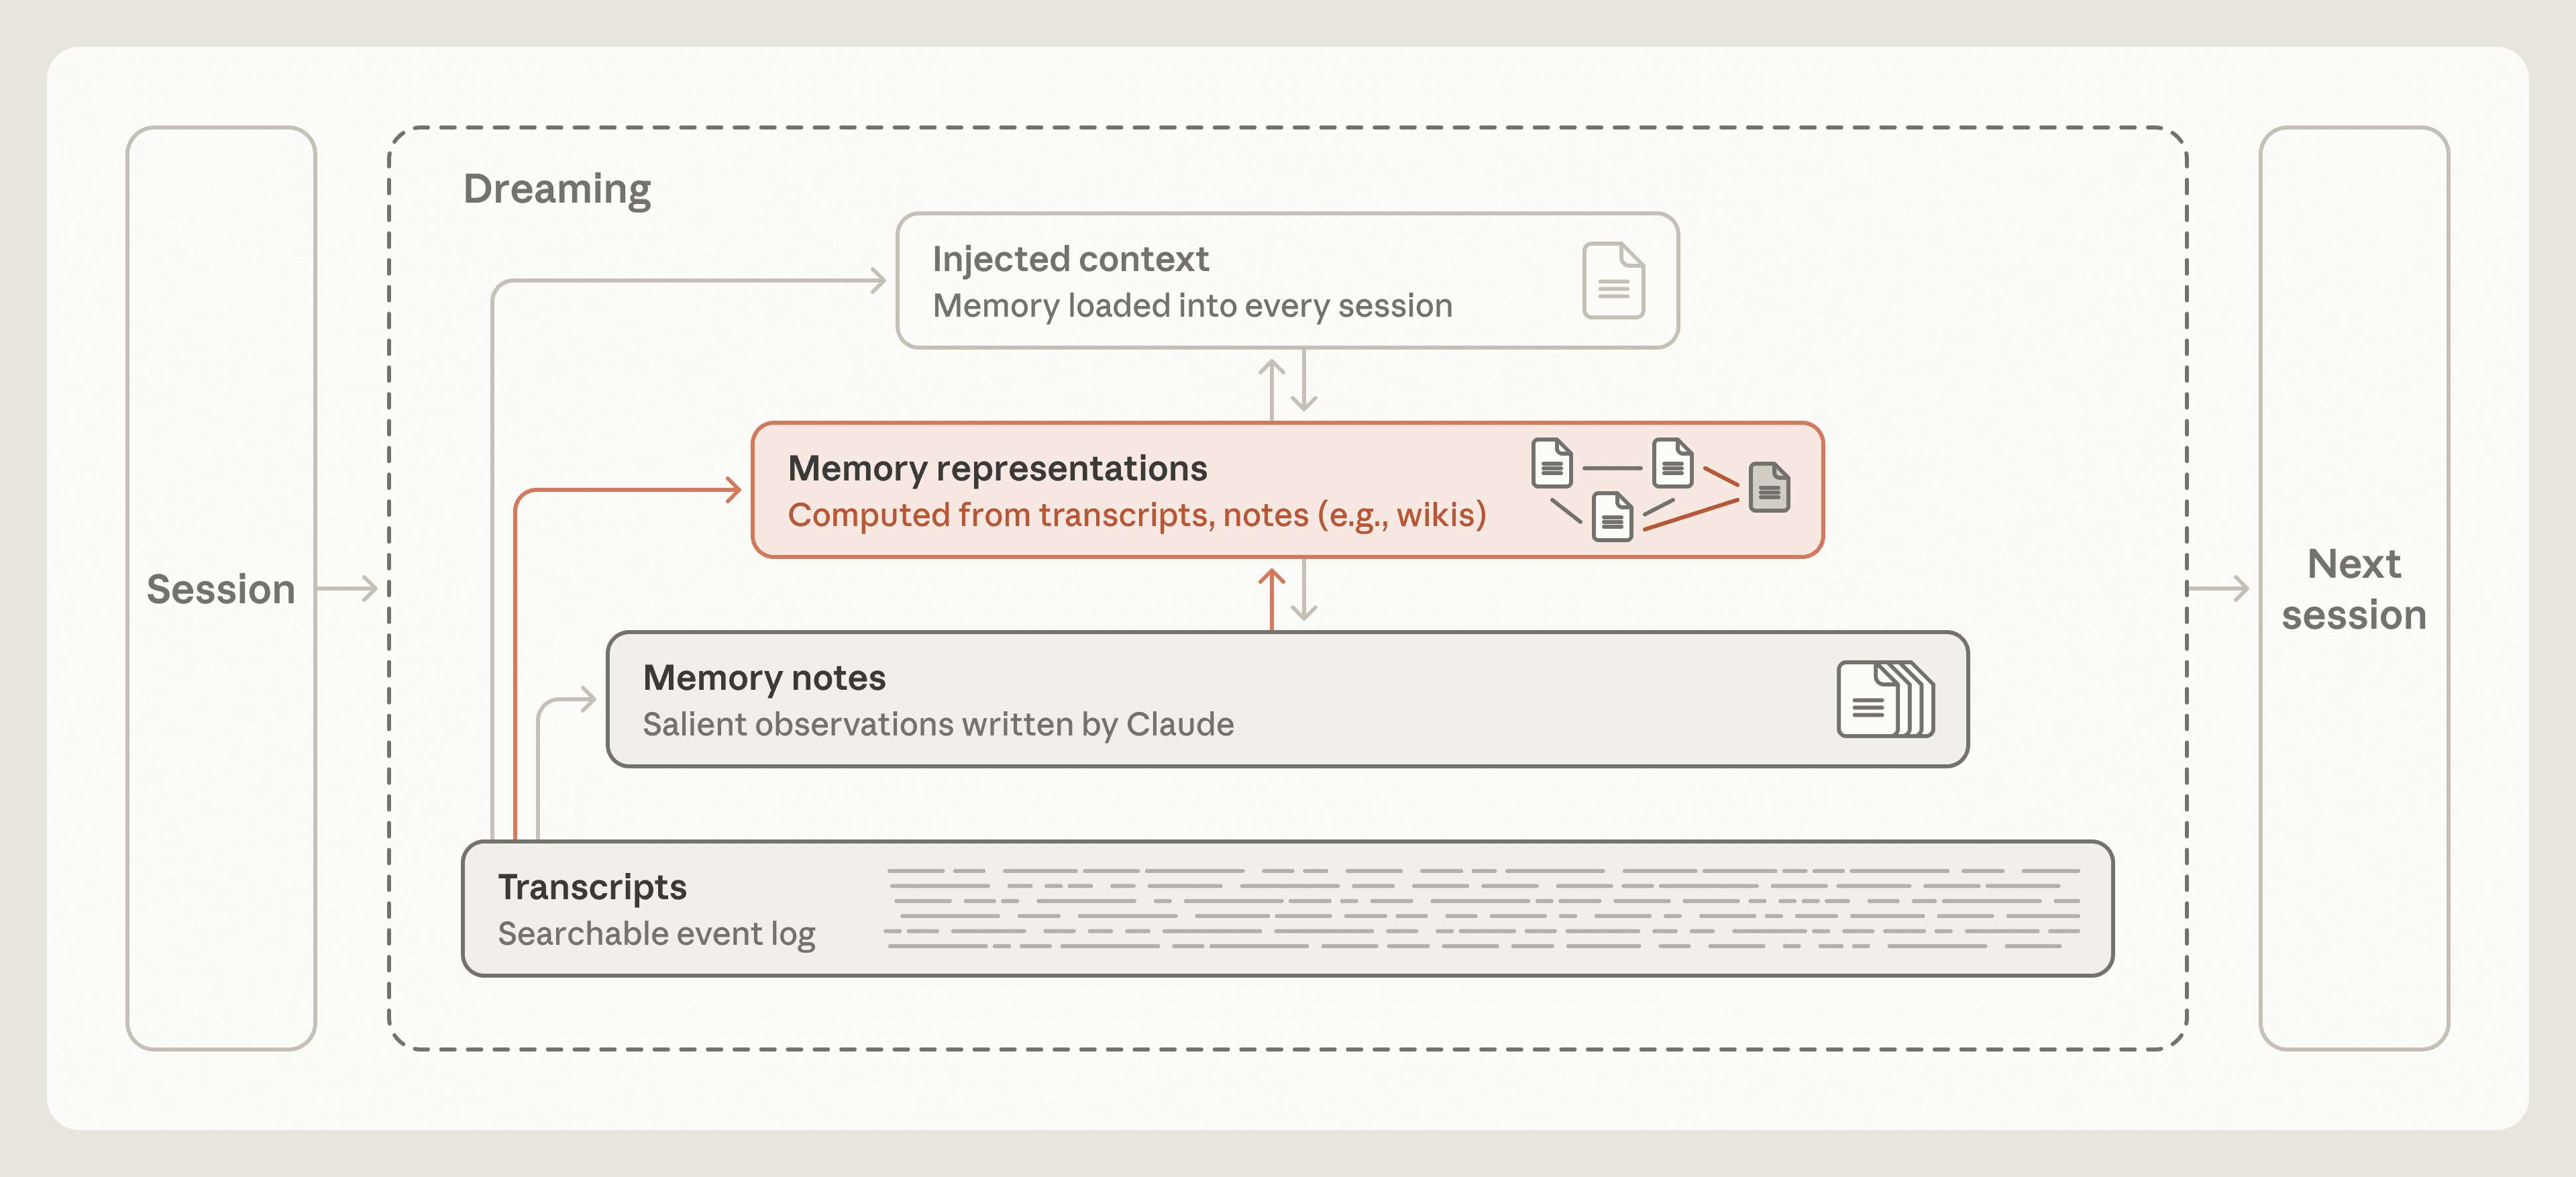
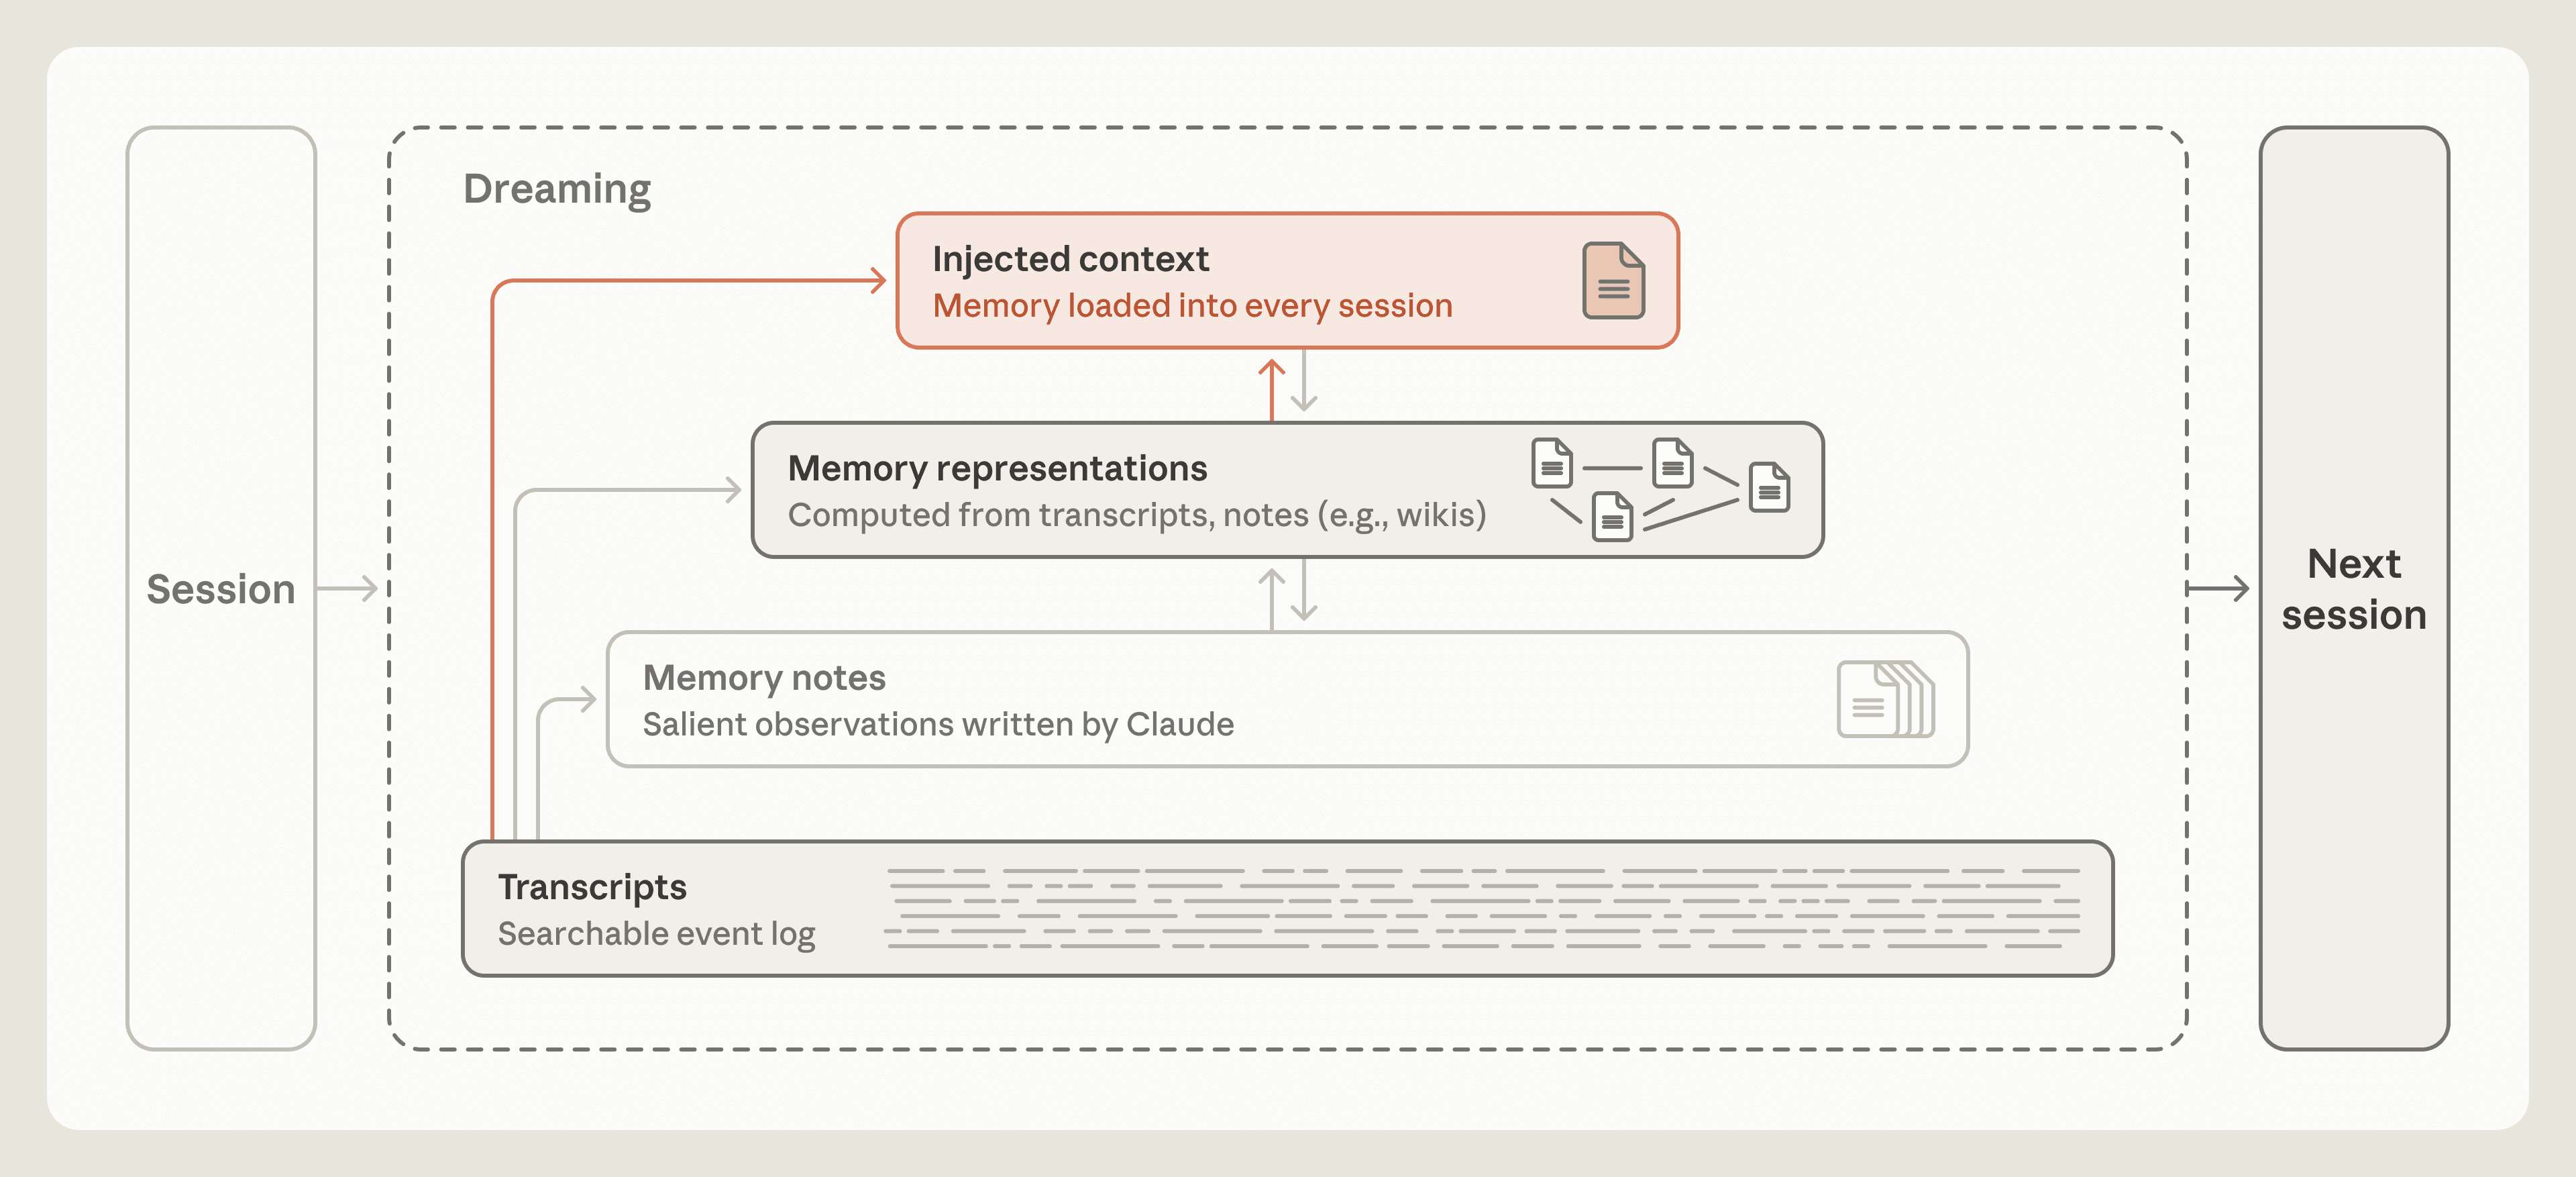
Agent 的记忆机制同样采用了这种“分工协作”。Agent 会在日志或对话记录中实时捕捉大量工作内容;而来自 Letta 和加州大学伯克利分校的研究人员则提出了“睡眠期计算”(Sleep-time compute)的概念:利用两次交互之间的空闲时间,让模型重组现有上下文。同样的思路能帮助 Agent 组织记忆——通过对日志进行“反思”,纠正此前犯下的错误,或生成全新的笔记与知识表征。这一过程被形象地称为“做梦”(Dreaming)(如图 1 所示)。
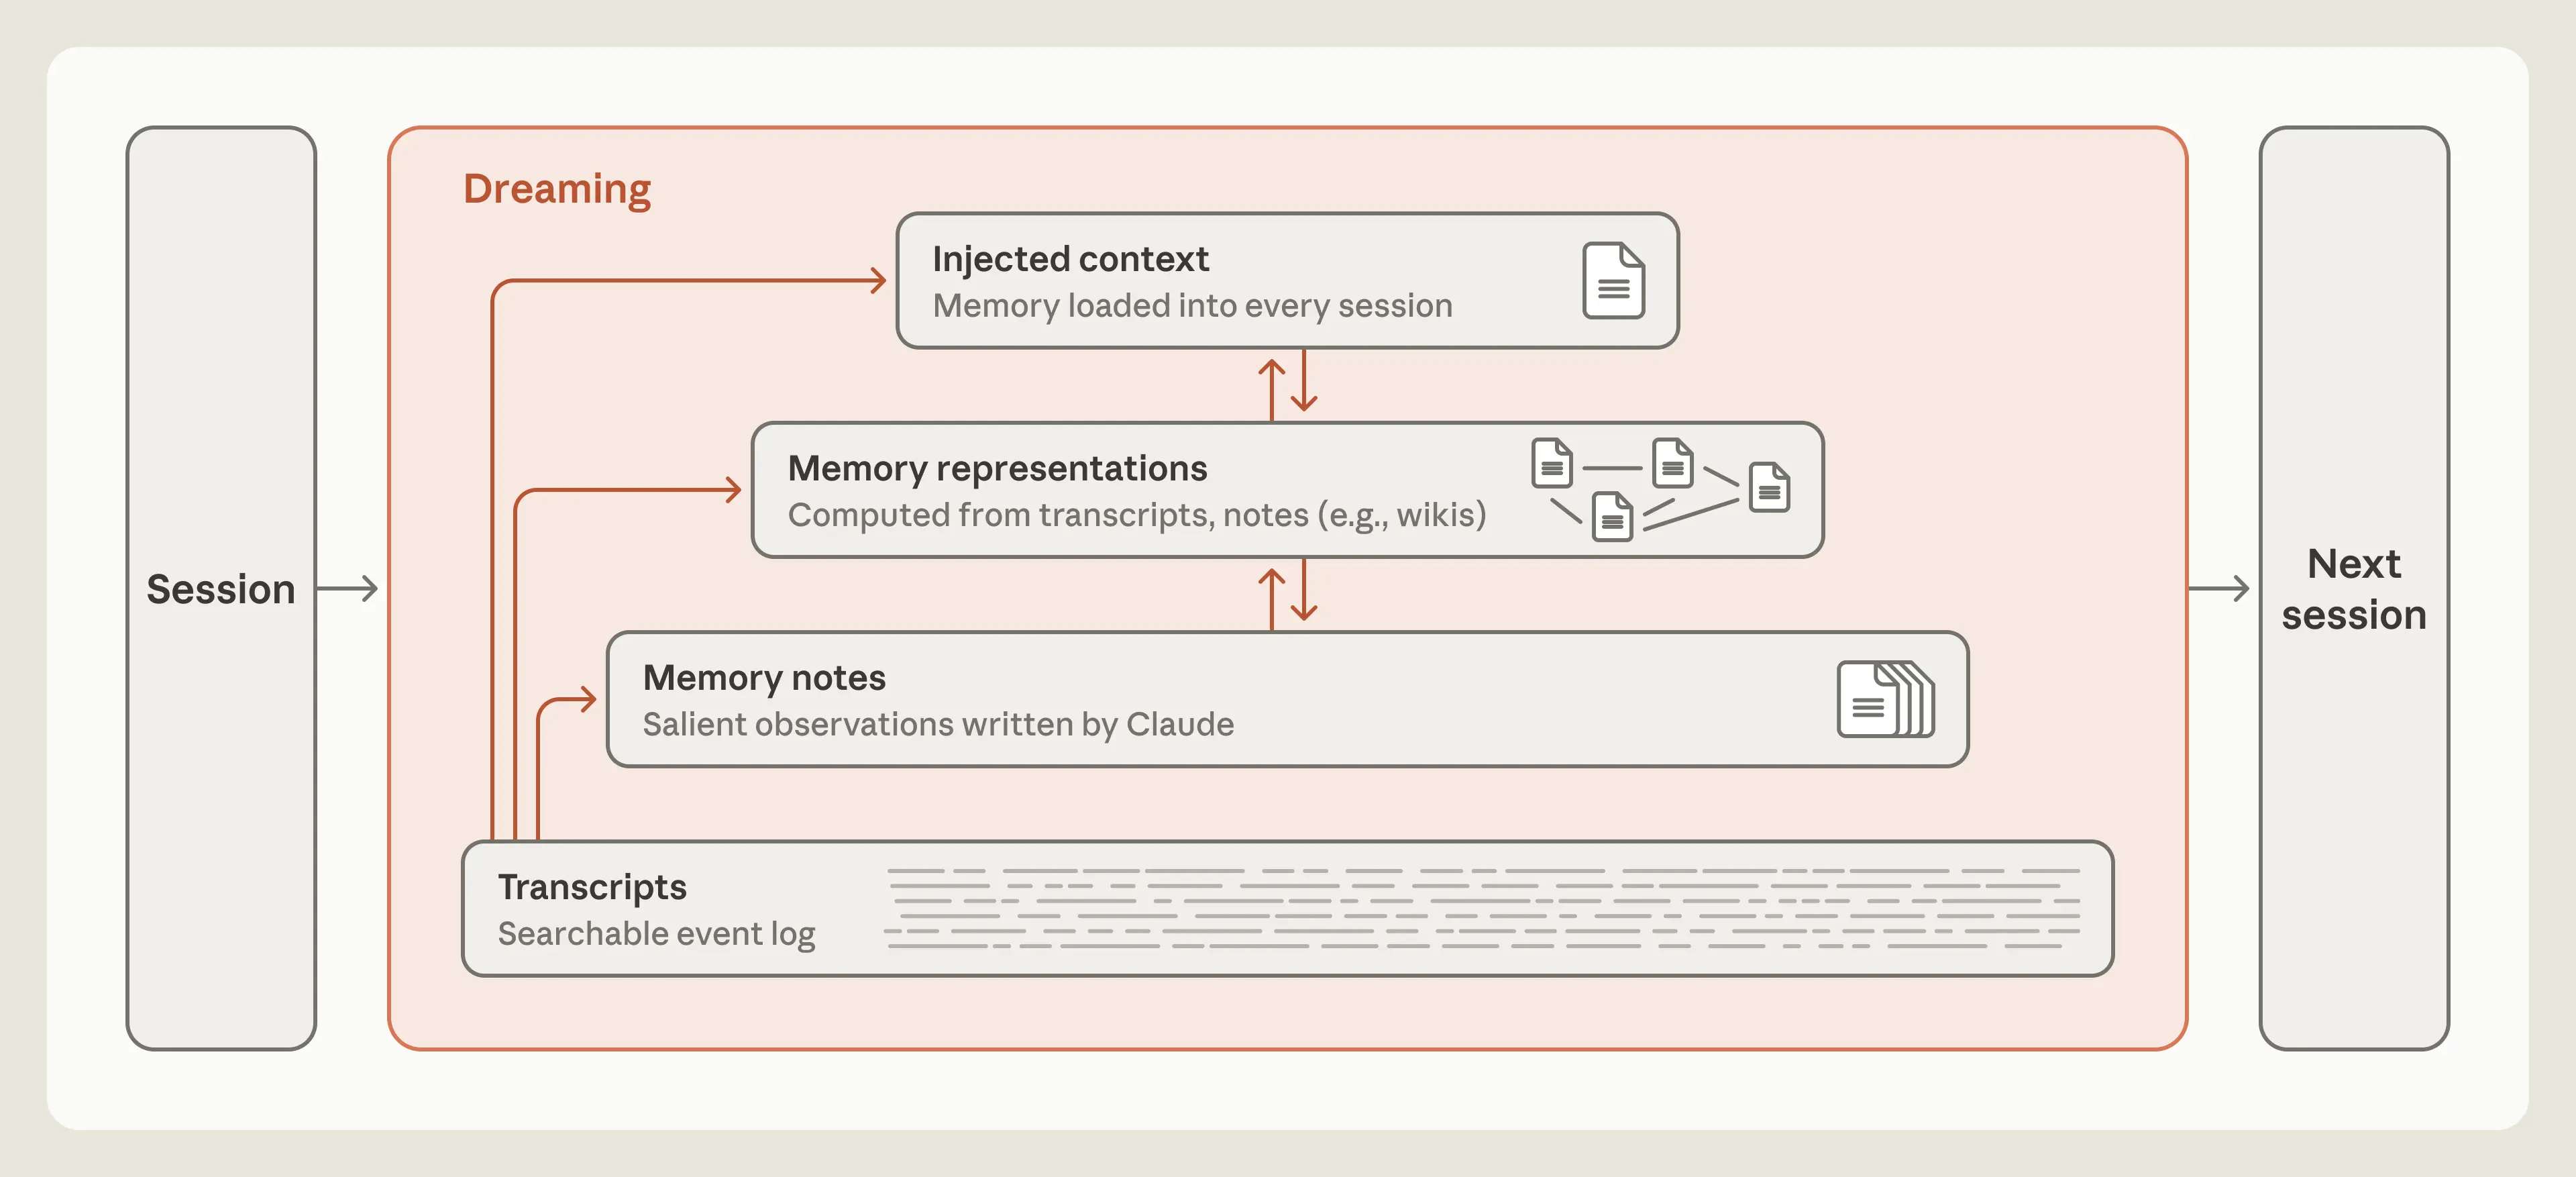
如图1所示,Anthropic提出了Agent Memory的四层架构:
- Transcripts:会话记录,可搜索的事件日志
- Memory notes:记忆笔记,由 Claude 写下的重要观察
- Memory representations:记忆表征,从记录和笔记中加工得到,例如 wiki
- Injected context:把最重要的信息注入到上下文,每次会话都会加载的记忆
橙色框 Dreaming 表示离线整理过程:它能从底层记录生成上层内容,也能在相邻的上层结构之间调整信息。
Memory notes
什么是Agent Memory?Anthropic 将其定义为:Claude 从过去经验(与用户交互、执行复杂任务)中获得的知识,且这些知识能够跨会话持久保留,作为后续调用的上下文。 这并不等同于大模型管理上下文的其他常见方式:
- 改变权重(模型在预训练或微调阶段写入的内部参数)
- 上下文学习 In-Context Learning(仅在单次对话内部临时获取的知识)
- 上下文压缩 Summary/Compression(用摘要替换较早对话轮次以腾出窗口)
在人脑中,一段经历发生之前、期间或之后释放的化学信号,可以将某段记忆标记为重要。在离线期间,相比没有标记的记忆,被标记的记忆往往会被更频繁地重放。这个被称为“重放”的过程,有助于稳定这些记忆,并将其整合为长期记忆。
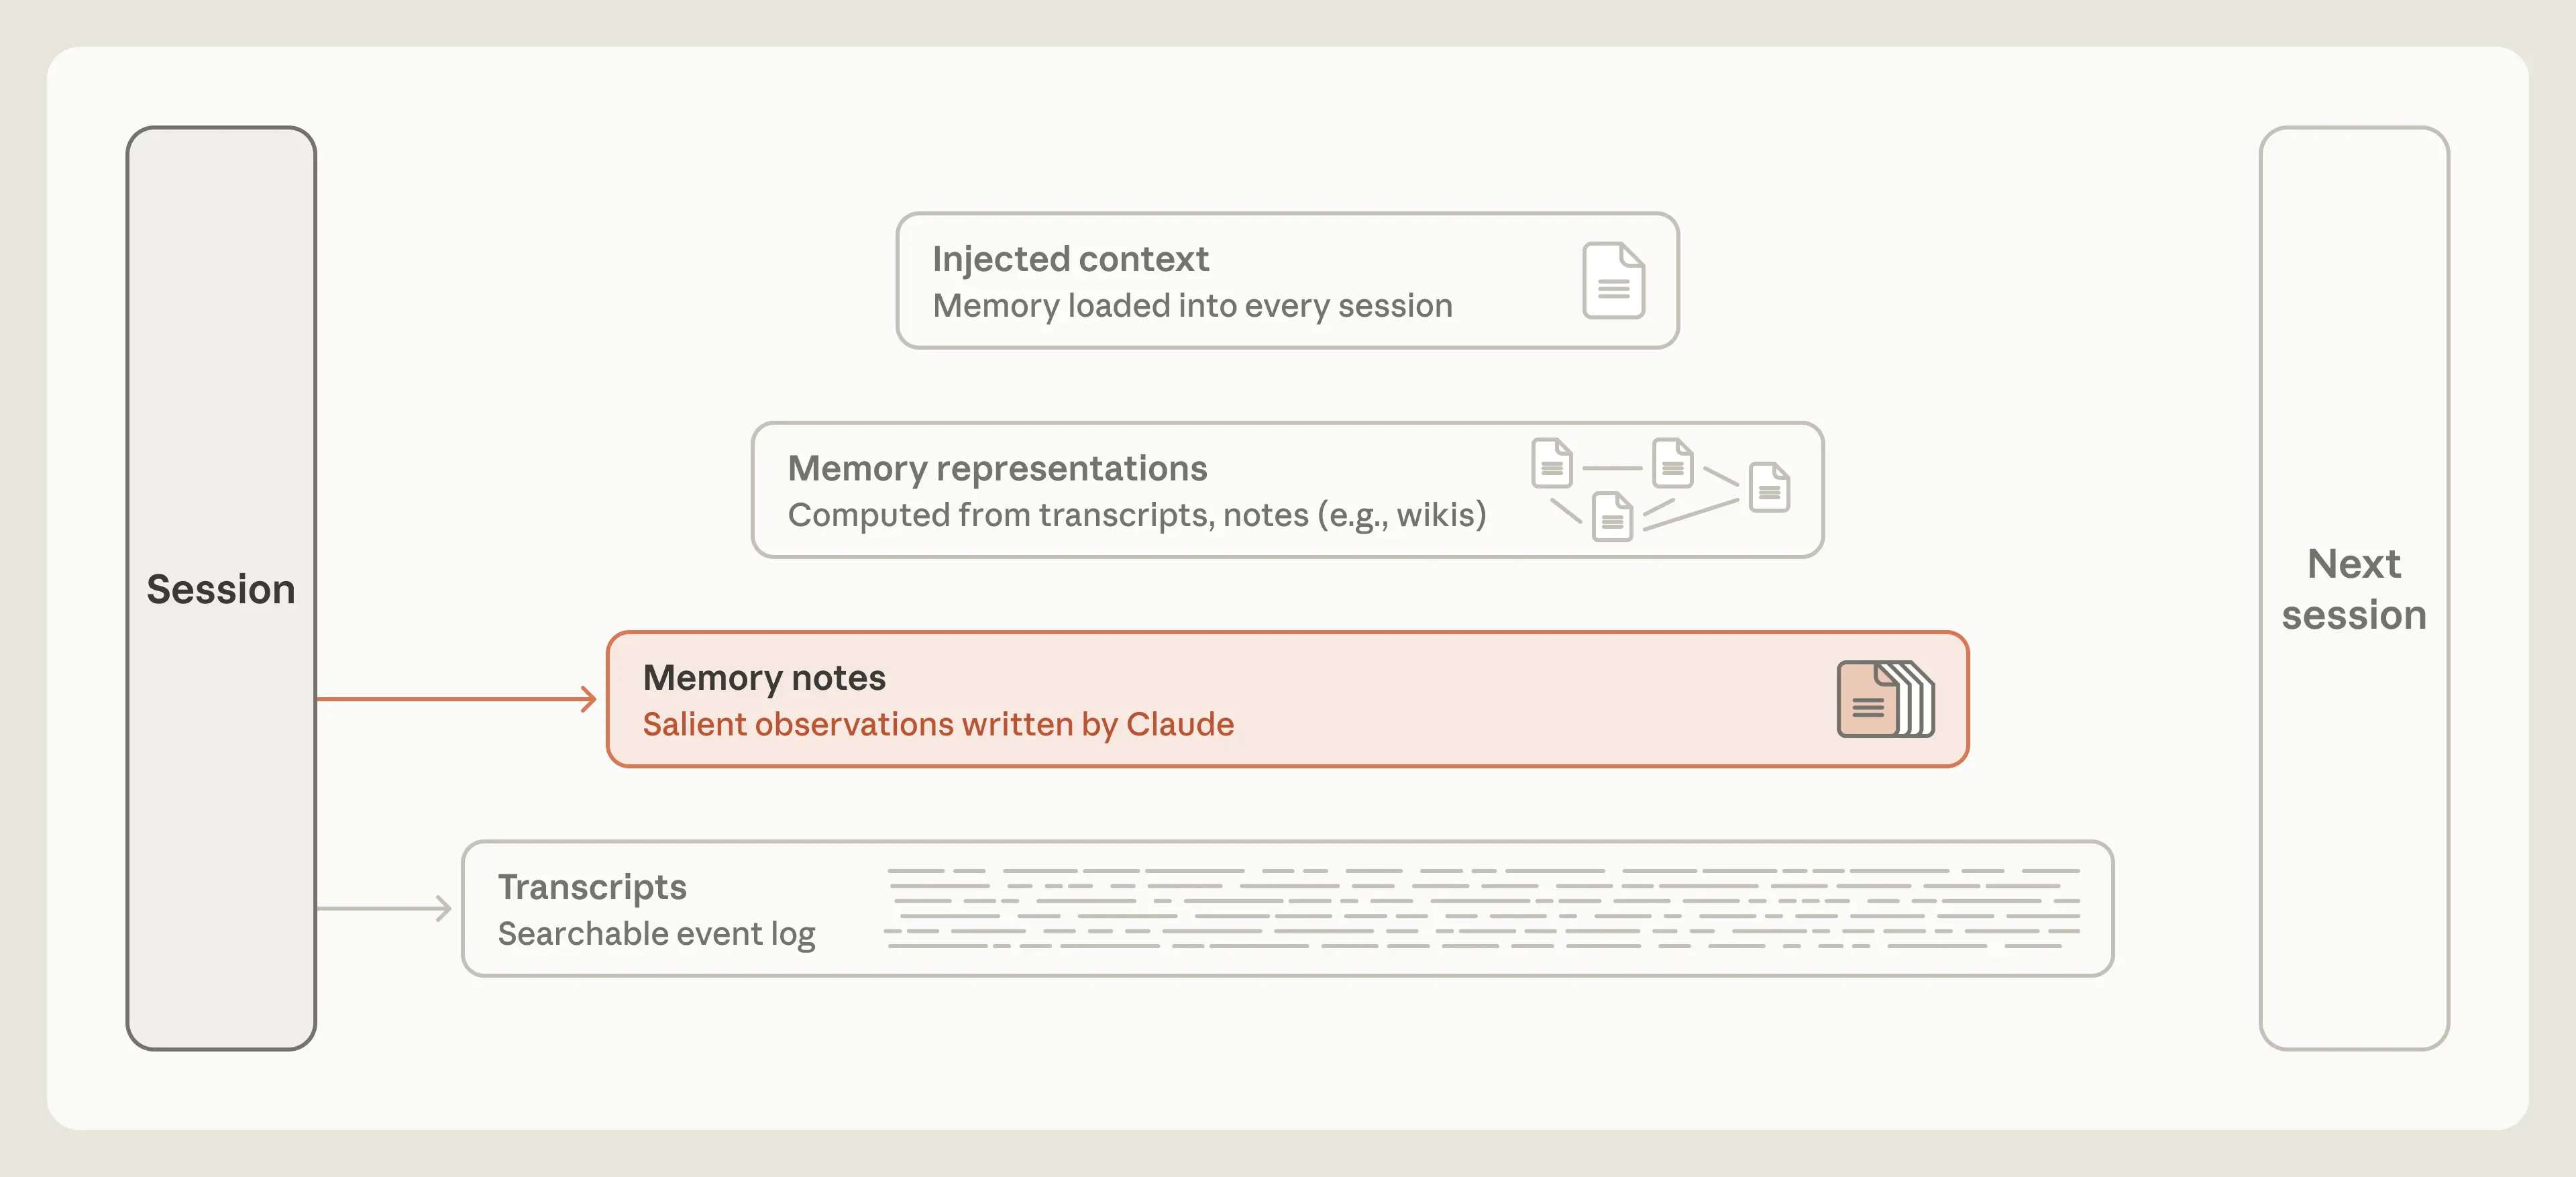
类似地,Claude 可以在重要事件发生时,为会话日志中的这些事件加上标记,使它们以后更容易被找到;也可以将其写入记忆存储,例如一个存放Memory notes的文件夹(图 2)。
记忆是对未来的预测:Agent 如何打通学习闭环?
记忆的本质,是对未来的一次次押注与预测。
当 Agent 写下一条规则时,它其实是在预言:“这条经验,我以后绝对还用得上。”比如它在数据库查询任务中踩了坑,写下了一条避坑指南,就等于给未来的自己买了一份“保险”。
他们使用 Claude Managed Agents运行了 CL-Bench 1.0(一项专门衡量 Agent 处理长程任务能力的基准测试)任务,每个问题都在一次全新的会话中开始,唯一的例外是:Claude 可以从一个跨会话持久保留的记忆目录中检索文件。
记忆可以在这里支持一个学习闭环。如果 Claude 答错了问题,它可以记录这次失败,提出关于出错原因的假设,检验这些假设,再将发现转化为指导未来作答的规则。
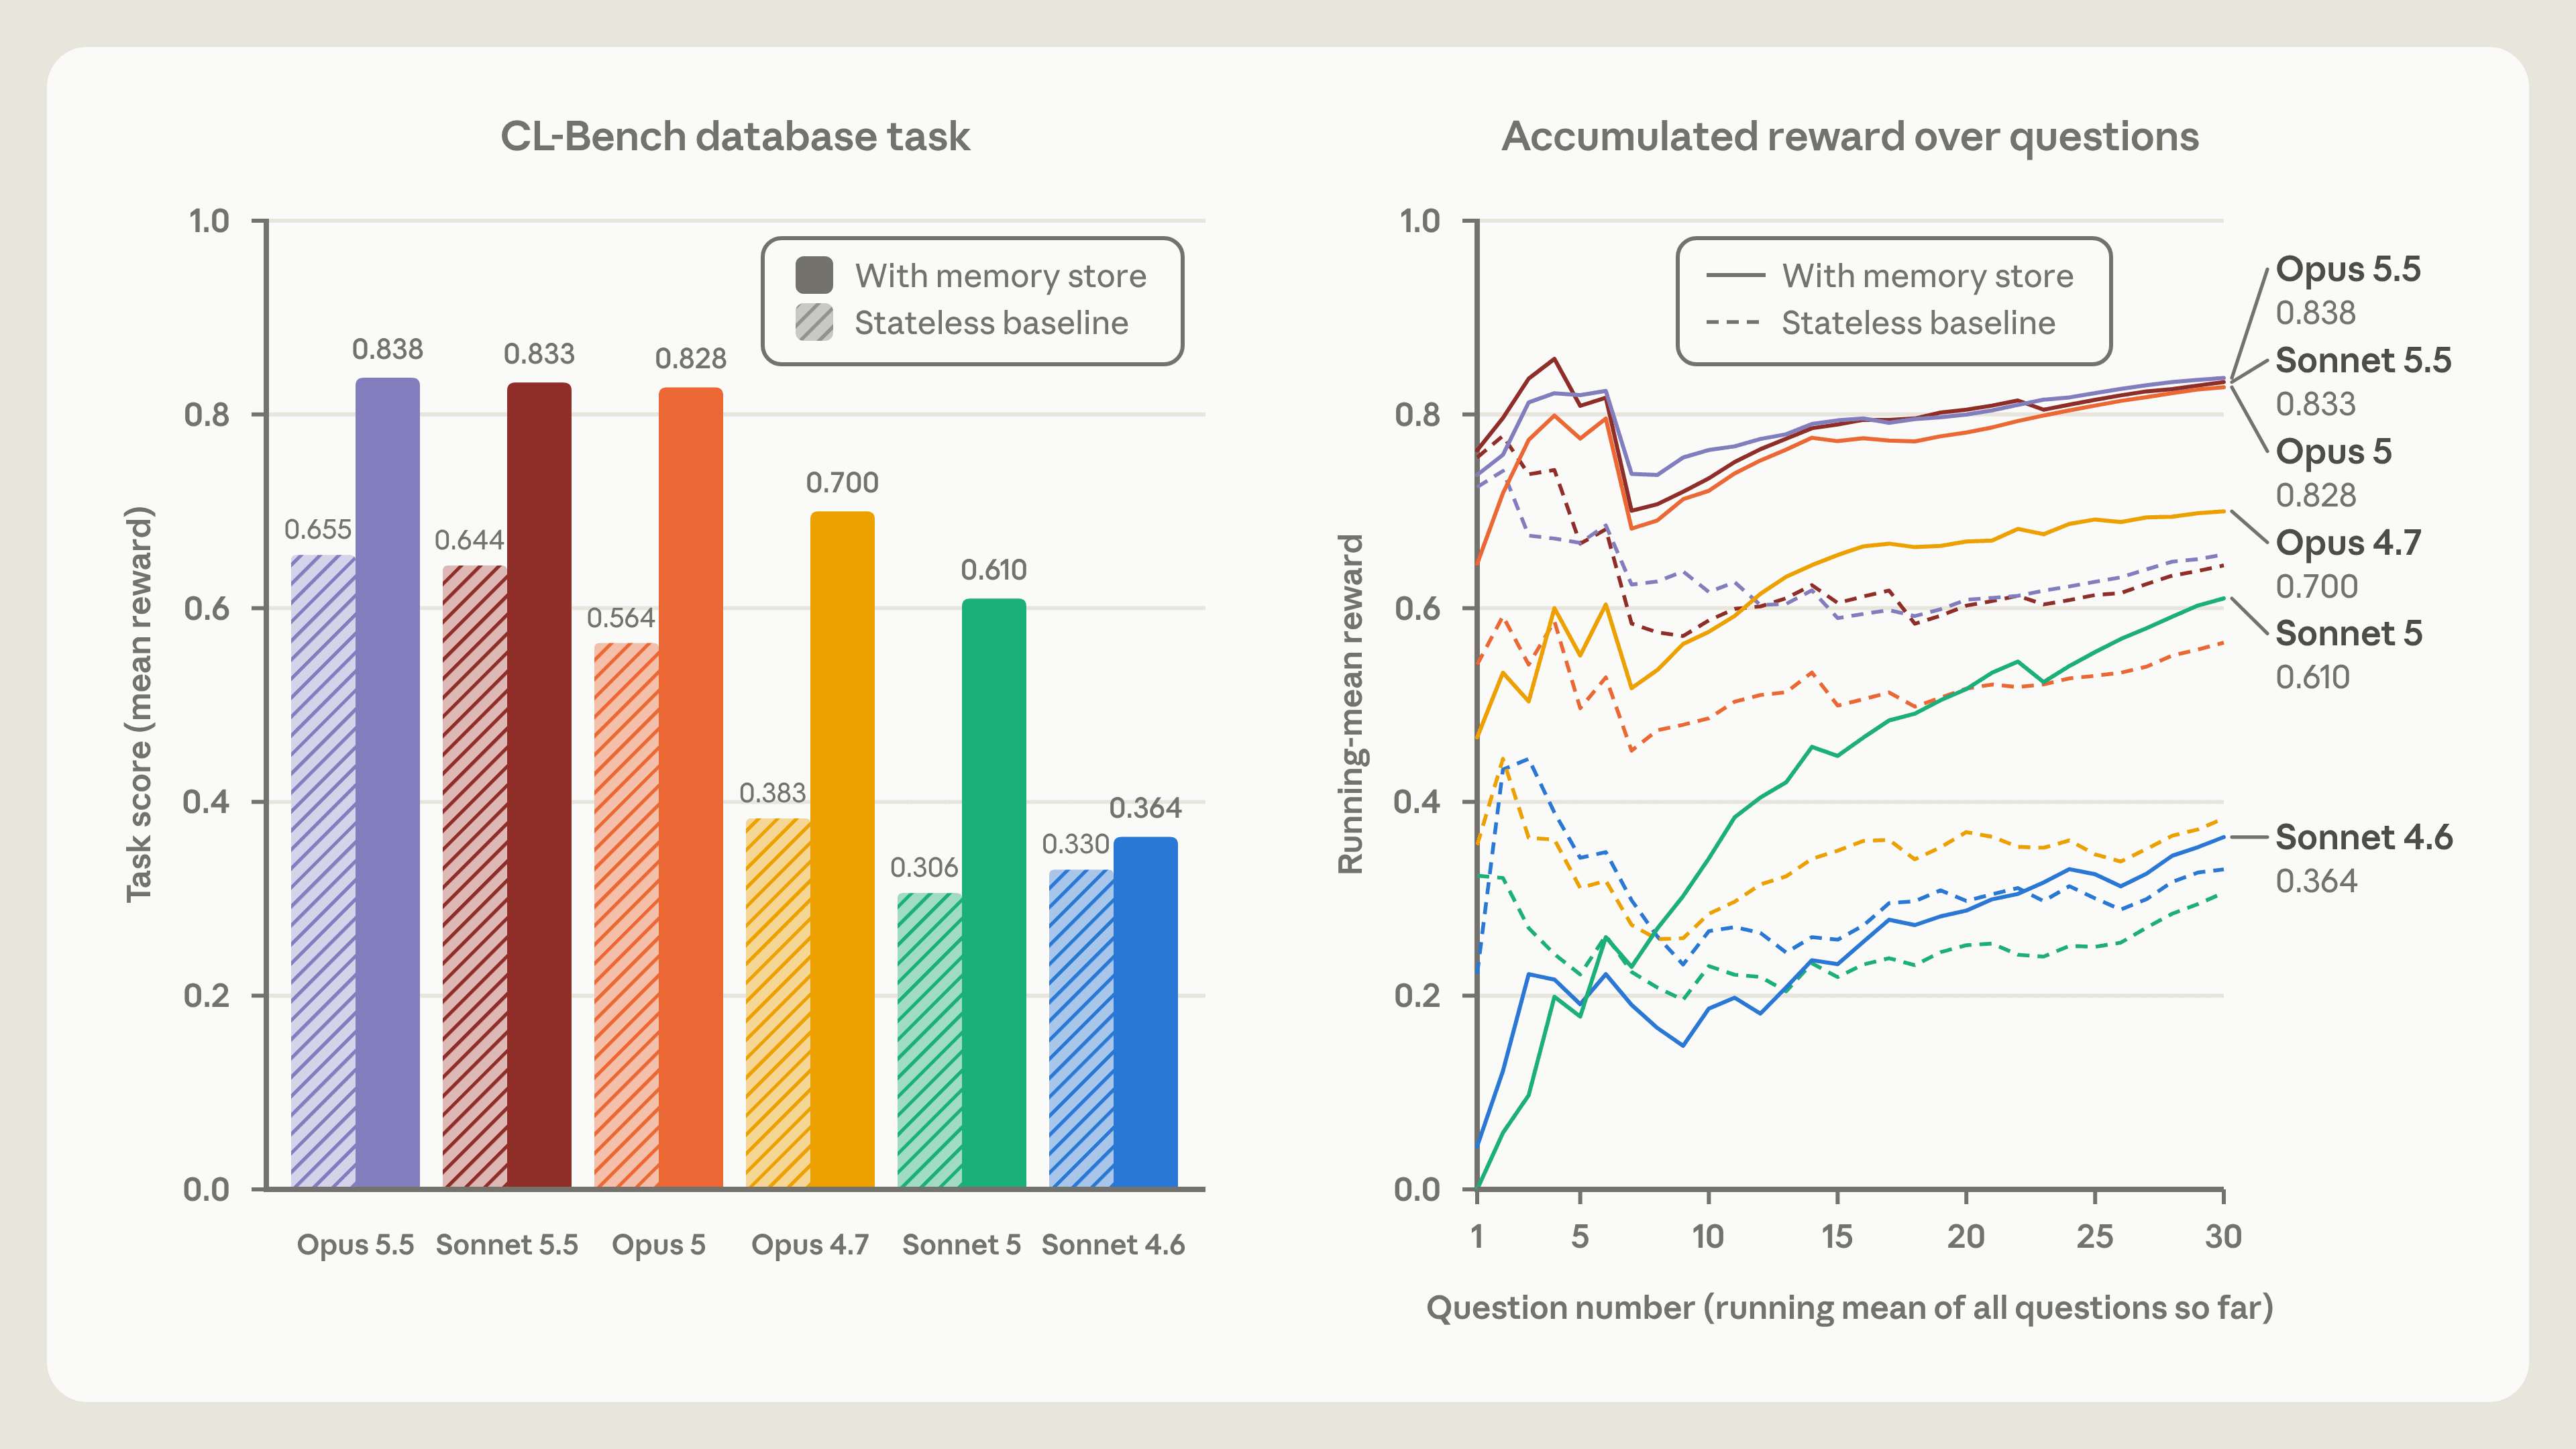
不同模型构建学习闭环的能力呈现出明显的阶梯演进:
- 初级阶段(Sonnet 4.6):只会把失败的猜测一股脑儿全记下来,目录里散落着一堆未经检验的胡思乱想,测试得分提升微乎其微。
- 进阶阶段(Opus 4.7 & Sonnet 5):开始分类整理,标注哪些事实被核实了、哪些还是未确认的猜测。
- 完全体(Opus 5 / 5.5):直接跑通了“试错 记录 验证 固化规则”的闭环。不仅记住了正确答案,还明确标注了避坑陷阱,综合得分直接从基线的 56% 飙升到了 82%+。
同时,Anthropic 还发现:别给大模型套太死板的规则。如果你硬性规定它“只能记录失败”,反而会把大模型原本的灵性压榨掉,表现大幅缩水。对于像 opus 5.5 这种高阶模型,放手让它自由判断“什么值得记住”,效果或许最好。
谁是合格的“记账员”?从《宝可梦》看记忆的极简哲学
为了测试 Agent 在长程复杂任务中的记忆筛选能力,Anthropic 让 Claude 去玩了经典的《宝可梦 红》。
在长达近 10,000 步的游戏中,Sonnet 3.7 和 Fable 5 展现出了截然不同的记忆风格:
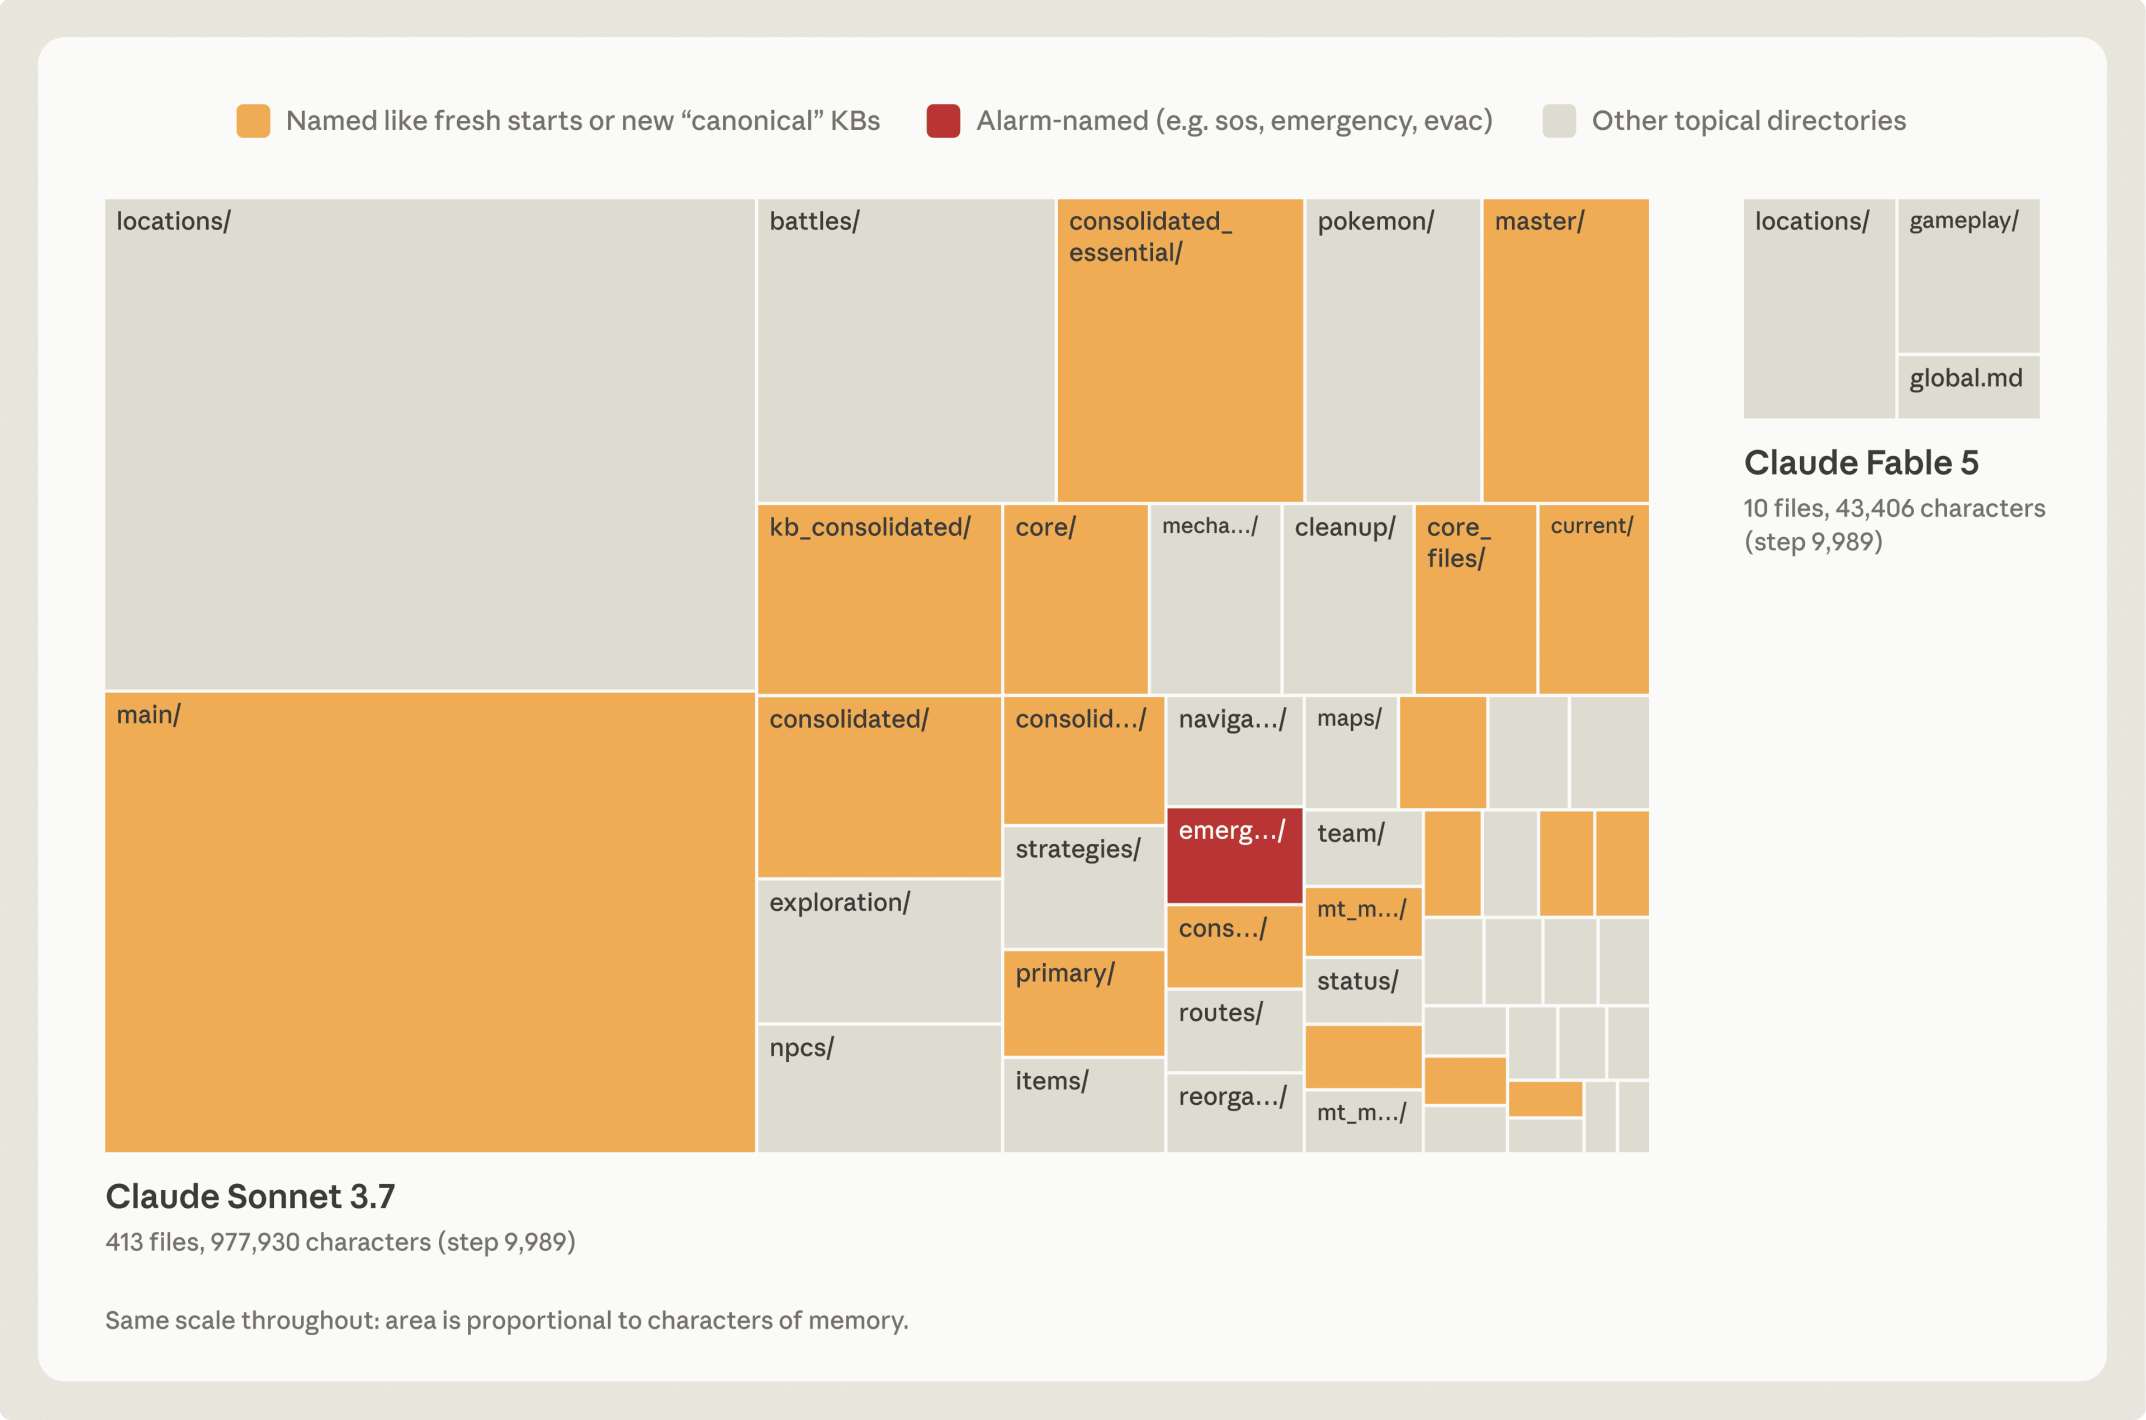
Sonnet 3.7(“强迫症”型):它觉得啥都重要。每场战斗、每件道具、每个 NPC 都要单独建文件,建了 413 个文件。然而游戏状态一直在变,记录转头就过时,它不得不花大量时间在“整理记忆”而非“打游戏”上,最后仅拿到了 1 枚徽章。
Fable 5(“极简主义”型):只写了 9 个文件加一个全局仪表板(global.md)。它只记录游戏没直接告诉它的机制——比如连续 7 个精灵球抓鲤鱼王失败后,它果断记下策略:“如果连续失败 3 次以上,就在菜单操作步骤间额外按几次‘等待’”。
最终 Fable 5 以极小的记忆库拿到了 4 枚徽章。Fable 5 的记忆文件夹小得多,却比 Sonnet 3.7 在游戏中走得远得多。Opus 5.5 也采用了类似做法:它维持一个小型Memory notes文件夹,用来跟踪当前目标和后续步骤,边玩边重写这些笔记,并最终通关。
引导 Claude 写入记忆:简单提示胜过繁复规则
给模型指令时,告诉它记忆是用来做什么的,比限定具体规则更有效。
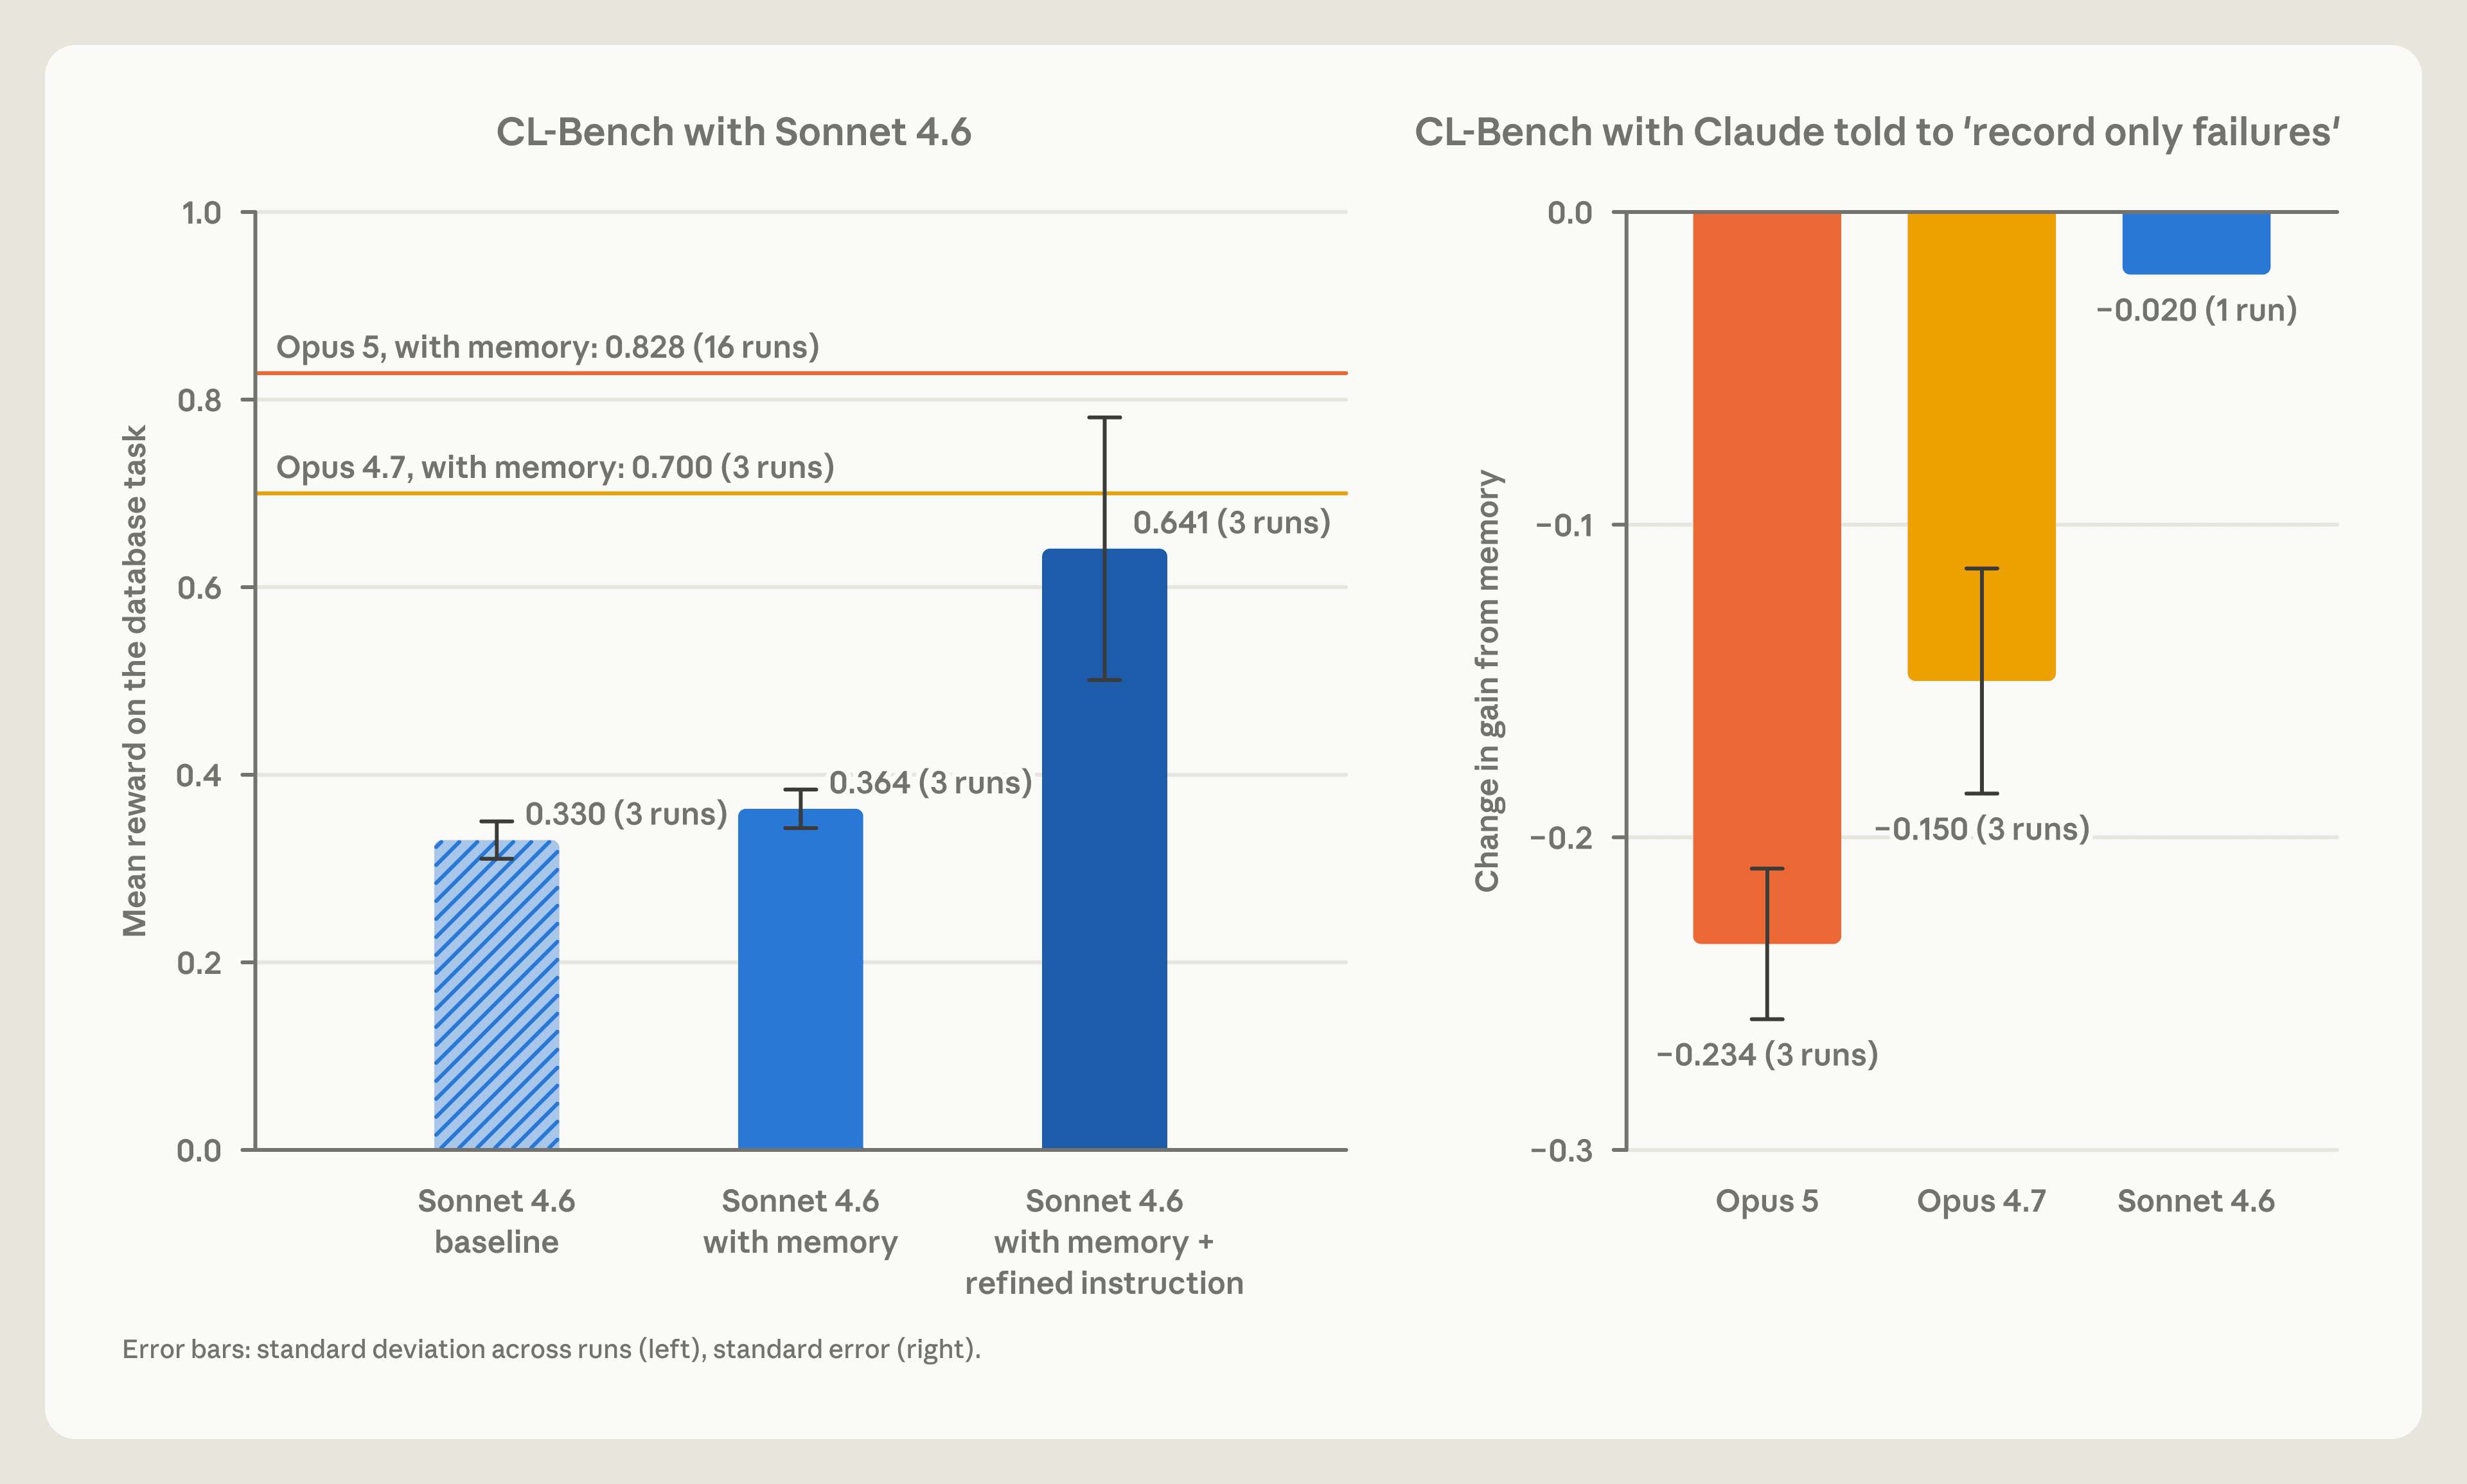
对于 Sonnet 4.6 这种较早的模型,提示它“在回答前先读取记忆并检验假设”,能直接让它的基准得分翻倍(从 0.364 升至 0.641);而 Opus 5 这种高级模型则具备很强的自律性,自由发挥往往能获得最佳收益。
为什么 Agent 需要“做梦”?
人类会做梦,Agent也需要“离线做梦”。
Claude 在会话中会根据当下对重要性的判断将信息写入记忆。因此,一条从一开始就写错了的笔记,或一条随着环境变化而逐渐失真的笔记,极有可能会在后续的会话中被 Claude 继续读取并盲目信任。
“做梦”机制赋予了 Claude 将笔记与原始会话记录对照核查的能力(图 6)。 Anthropic 在让 Claude 使用 Managed Agents 玩《宝可梦》并挂载记忆目录时,就观察到了一个非常典型的正面案例。
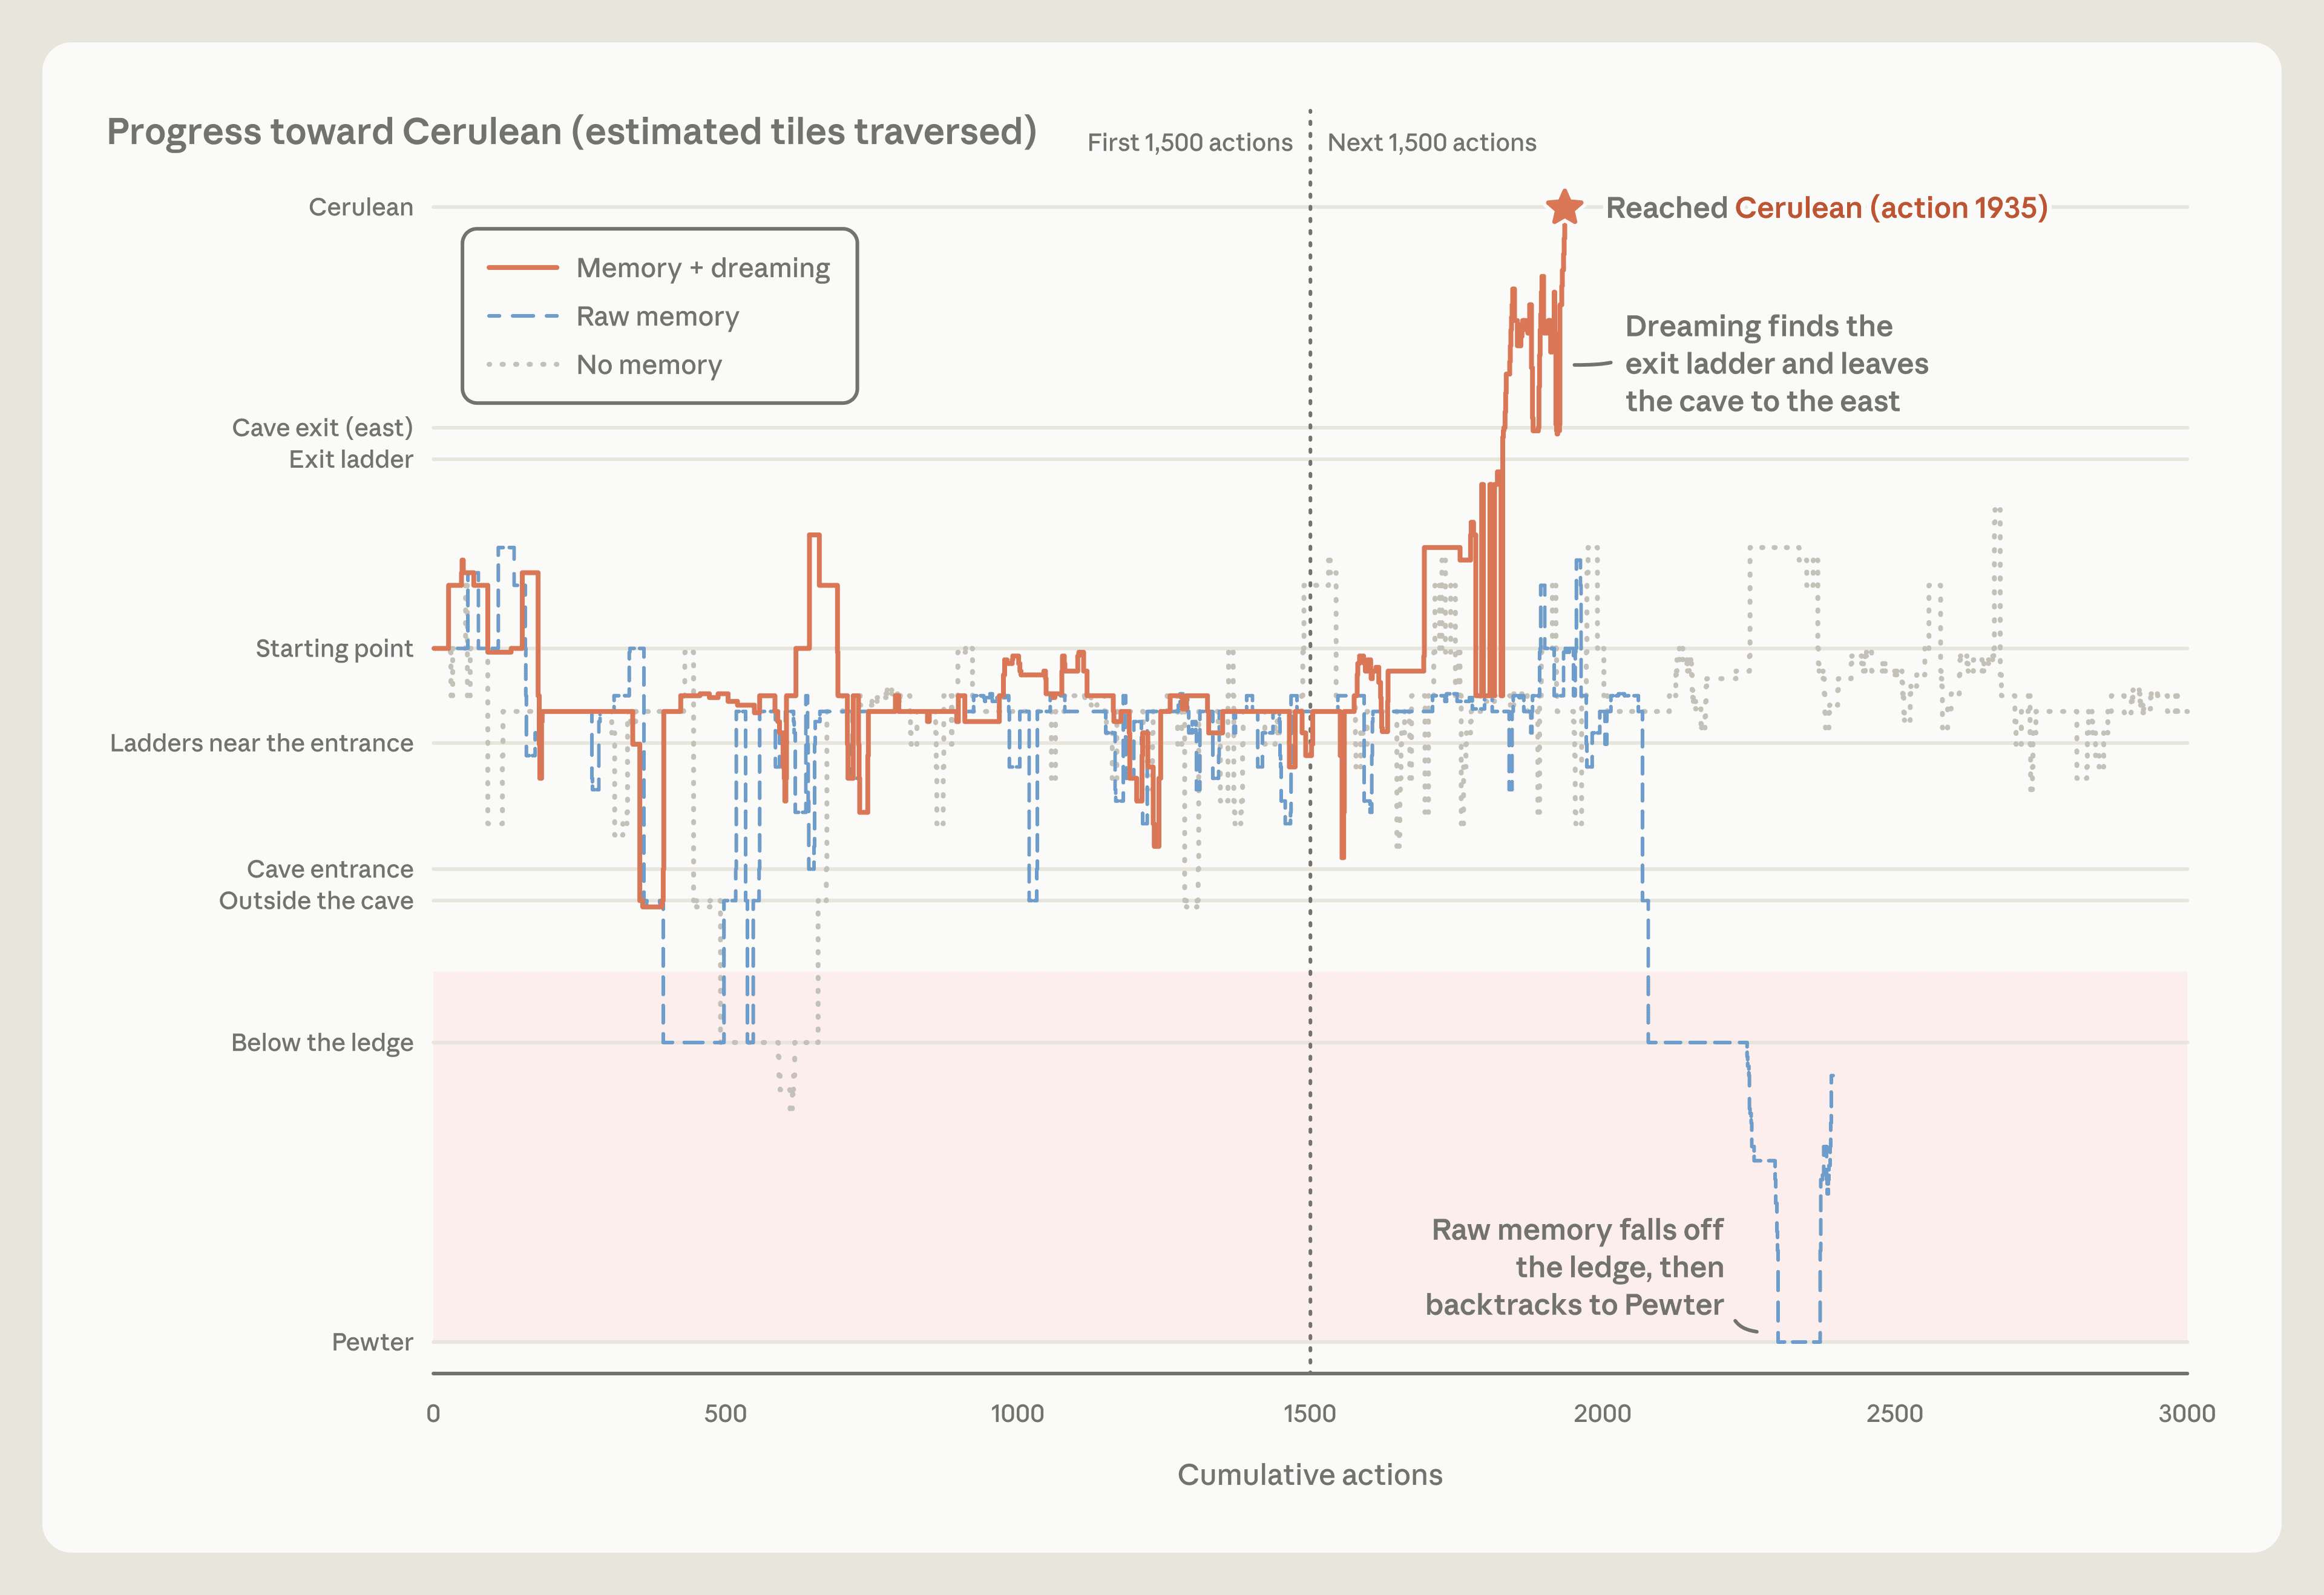
在《宝可梦》的月见山测试中,Claude 误以为宝可梦中心在山东侧,掉进单向台阶回到原点后,还在错误地记录“往西走过头了”,导致陷入死循环甚至产生放弃情绪。
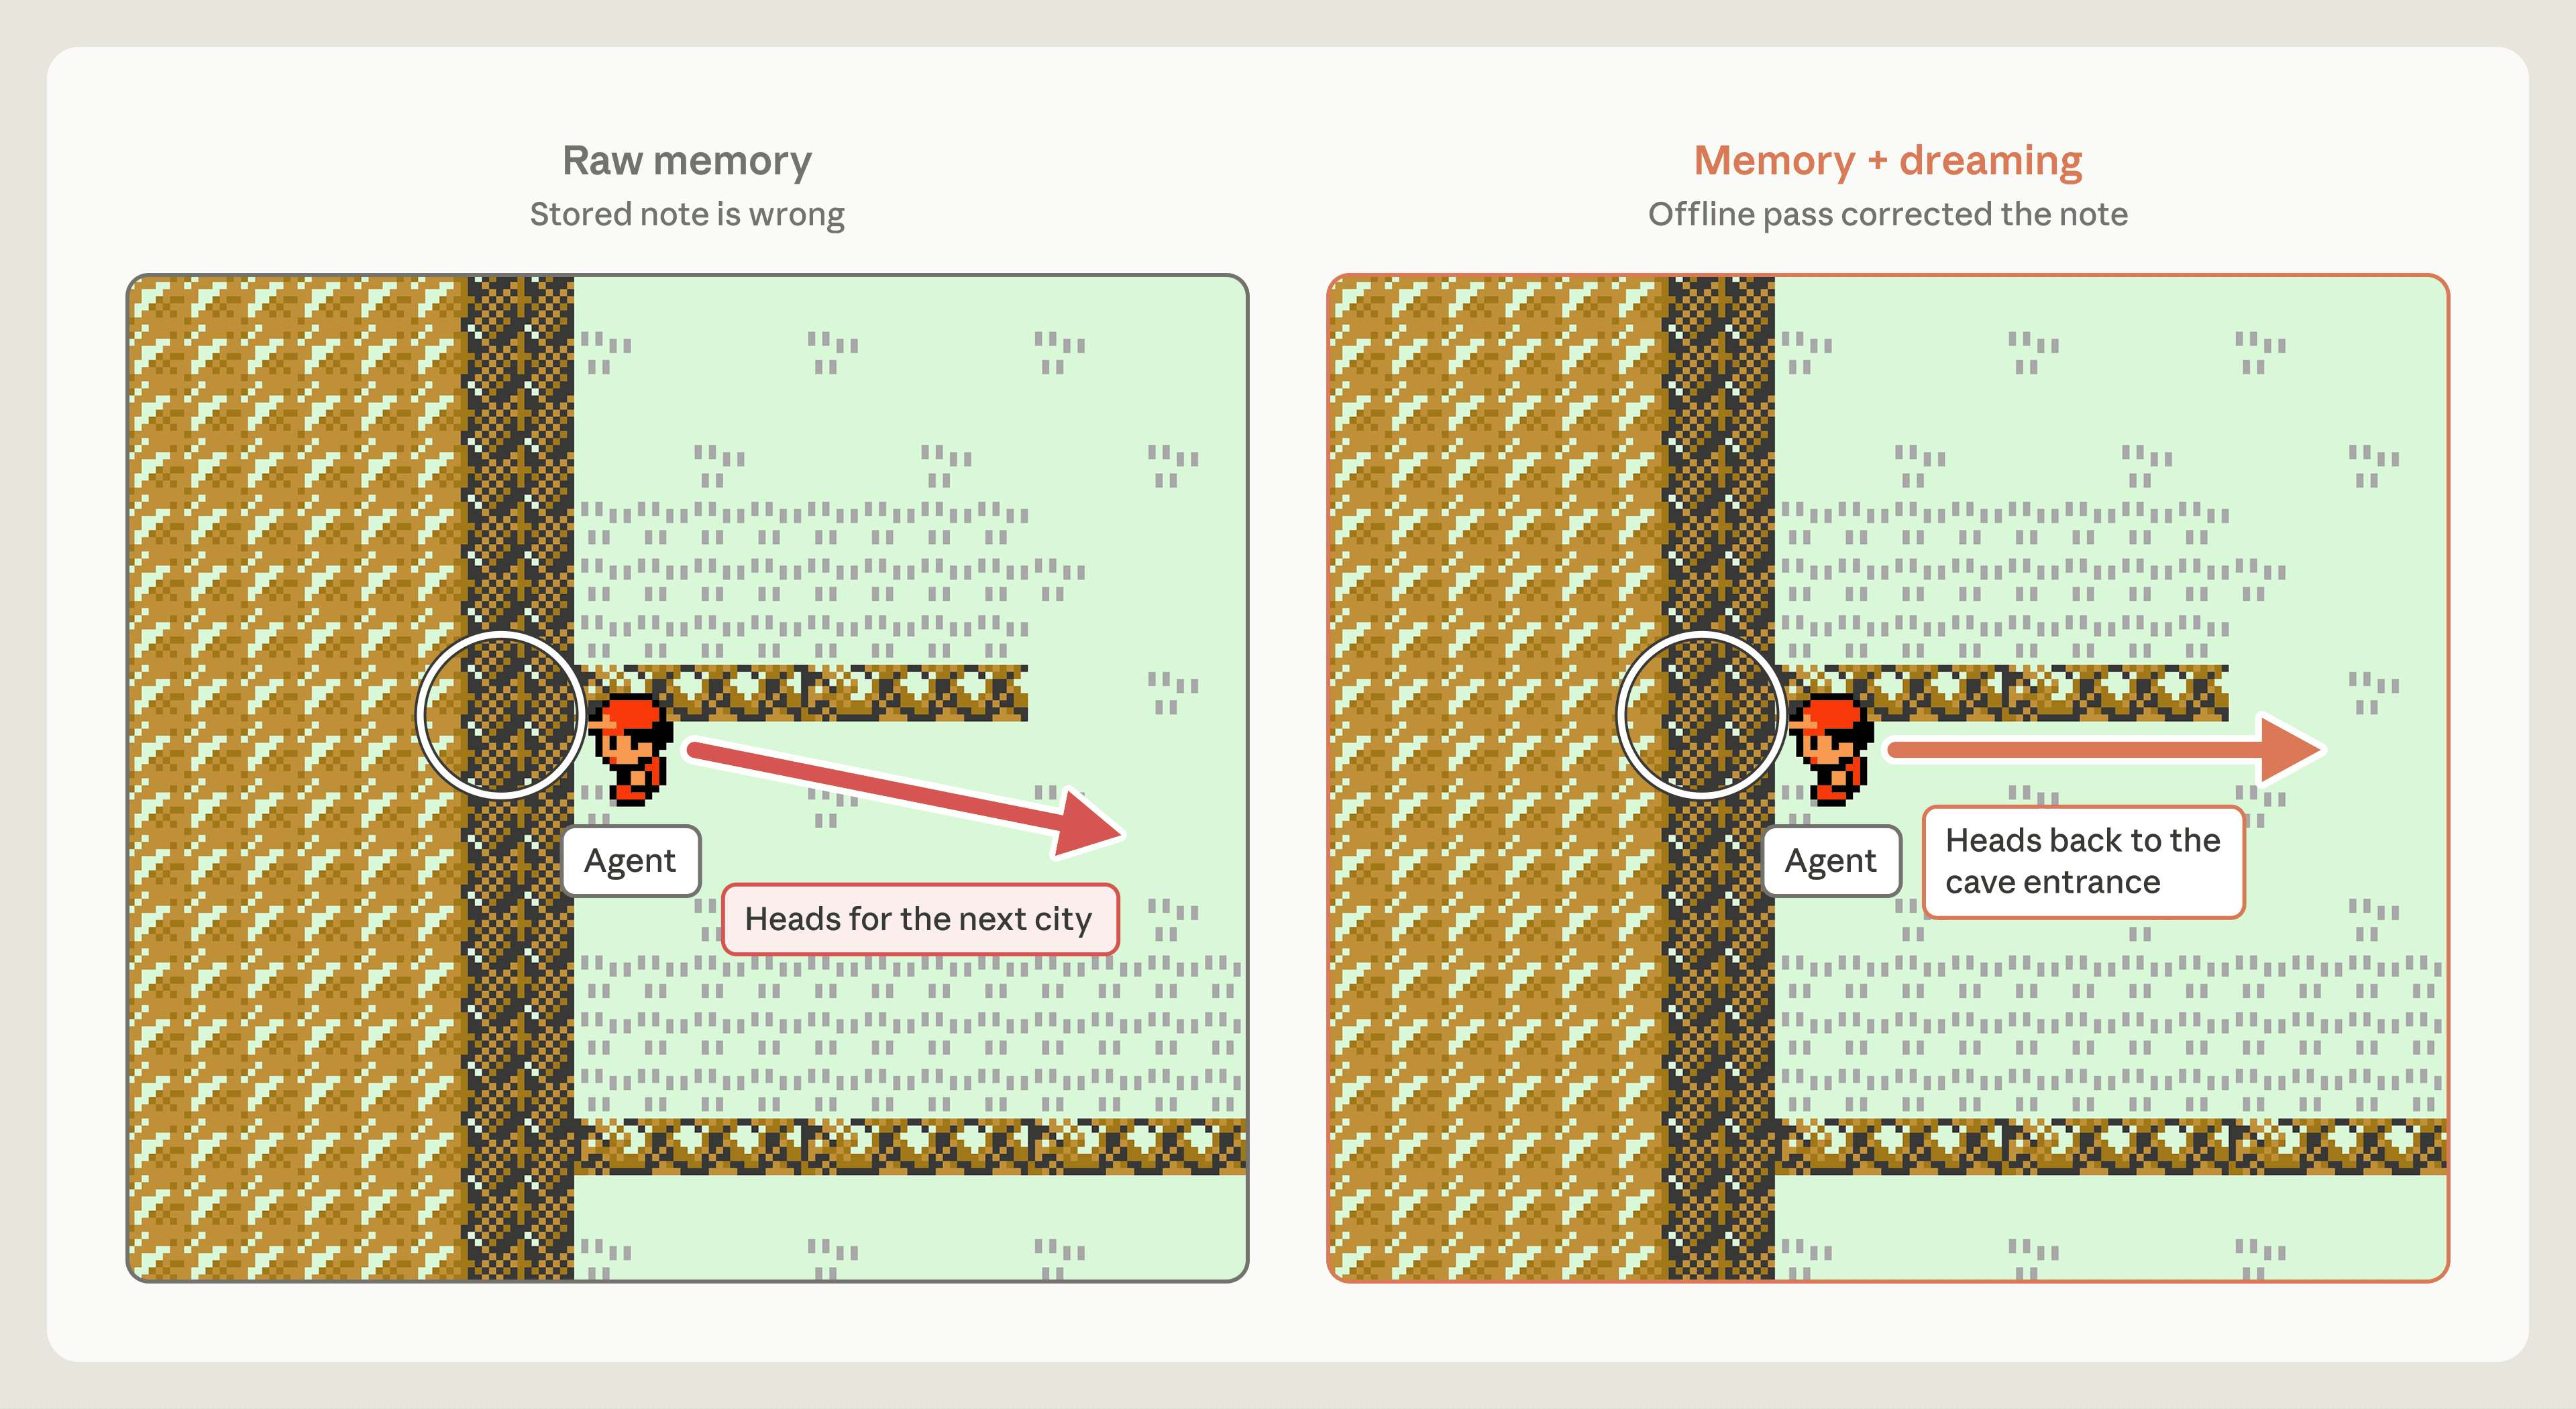
为了验证“做梦”能否帮 Claude 避开死循环,研究人员对这份错误记录了宝可梦中心位置的文件夹执行了“做梦”处理:Claude 将笔记与会话记录对照核查后发现了矛盾,并重写了笔记。会话记录作为真实的事实依据支持了记忆验证。在拿到修正后的笔记后,Claude 重新返回月见山洞窟,并最终成功到达了华蓝市。
而在使用未经修正笔记的对照实验中,Claude 先后三次掉回先前的道路。第三次失败后它甚至萌生放弃意图,在笔记中写道:“我准备停下,不再这样循环了。” 即使被实验设置要求继续,它也只能一路退回山前的深灰市补给物资,直至运行结束都未能到达华蓝市。
从散装笔记到知识结构:Wiki 记忆表征的威力
除了纠错,“做梦”还能帮 Agent 搭建像 Wiki 一样具有网络链接结构的记忆表征,这是由 Claude 编写和维护的一组页面,汇集它对某个主题所知道的内容,并链接到其他笔记。这些链接实际上为 Claude 提供了一张地图,使它能够梳理记忆,并在需要时高效找到相应内容。
Anthropic 基于 35 万份内部文档(约 4.2 亿 token)进行了压测,让 Opus 5 在 128 次离线“做梦”中不断迭代 Wiki 知识库,在128轮session中逐步编写或纠正相互链接的 wiki 页面,合并重复内容,并对照来源核查陈述。
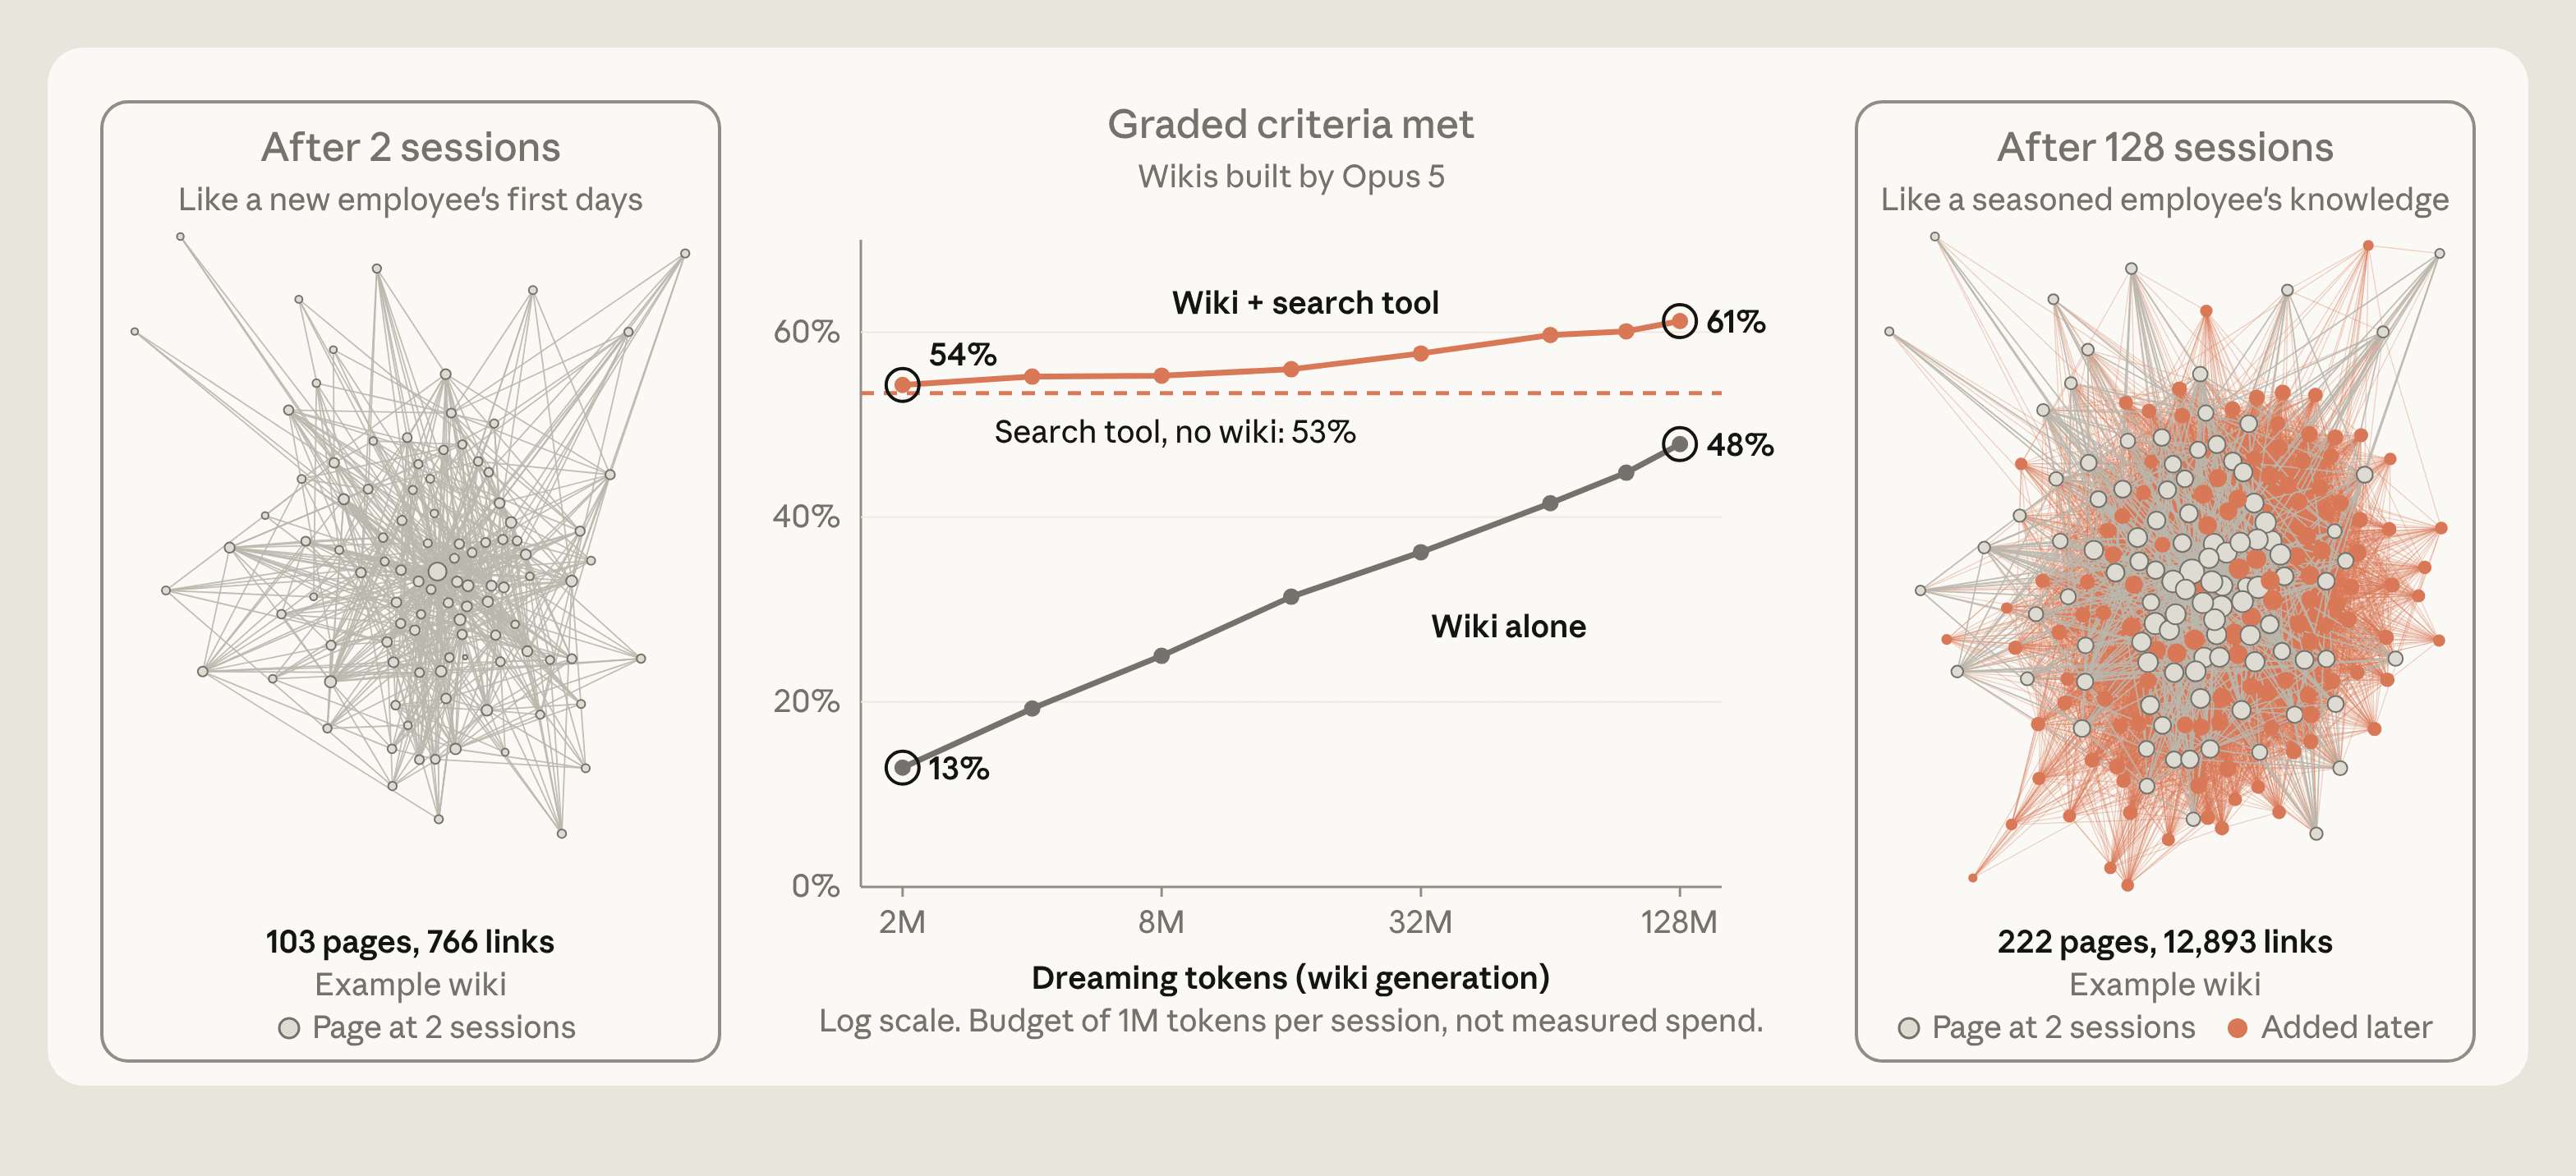
从 2 次会话时的“萌新状态”(103 页面、766 链接,得分 13%),发展到 128 次会话后的“资深专家”(222 页面、12,893 链接,得分 48%),结合文本搜索后综合准确率更是高达 61%,且单次问答能节省约 2万 Tokens。
研究团队还测试了因Claude拥有wiki而受益的任务,采用了 Harvey LAB 基准测试以及一组有关某次并购的文档,这项基准测试会给 Claude 一组文档,并要求它依据文档内容生成一份法律简报,然后根据一份标准清单为简报评分。这些评估也许不像玩一局《宝可梦》那样有趣,但它们提供了多样的文档集合用于构建 wiki。
基于这些文档Claude构建了wiki,分别测试了使用wiki和直接文件搜索回答有关并购问题的情况,或生成法律简报。在这些项目上(红色和橙色连线),Claude查阅wiki时的得分(73% → 87%)是显著提升的。
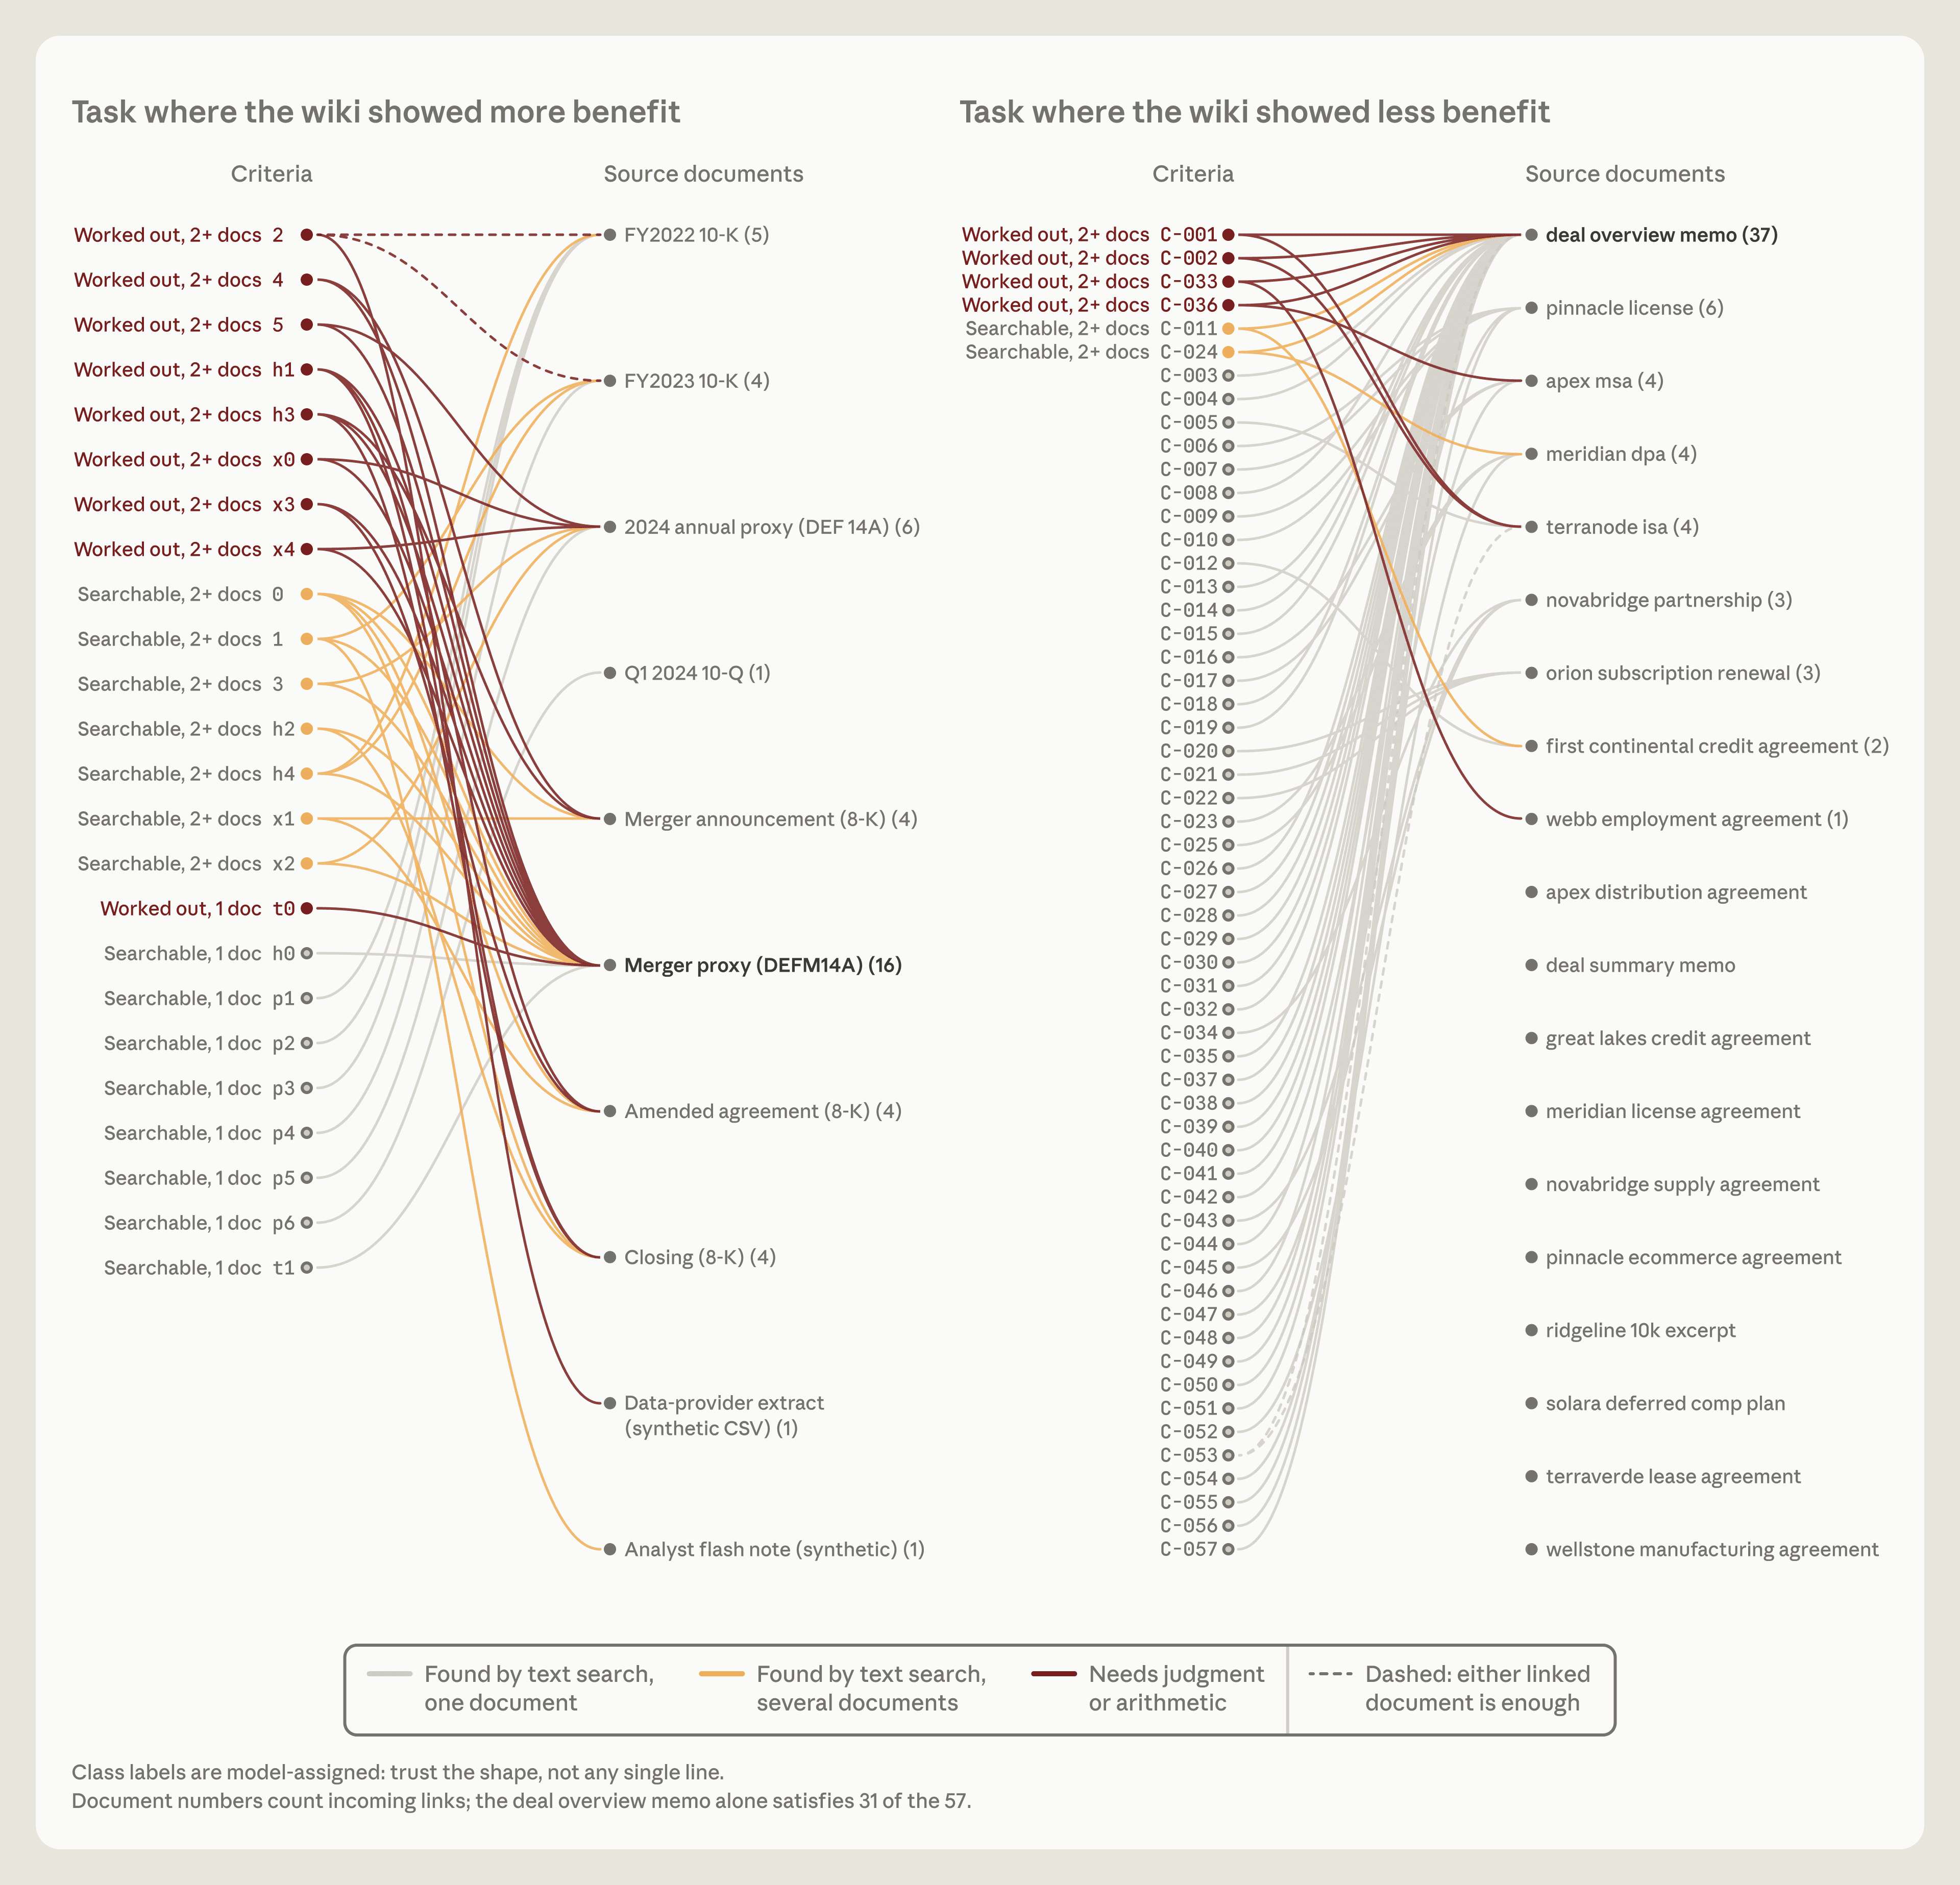
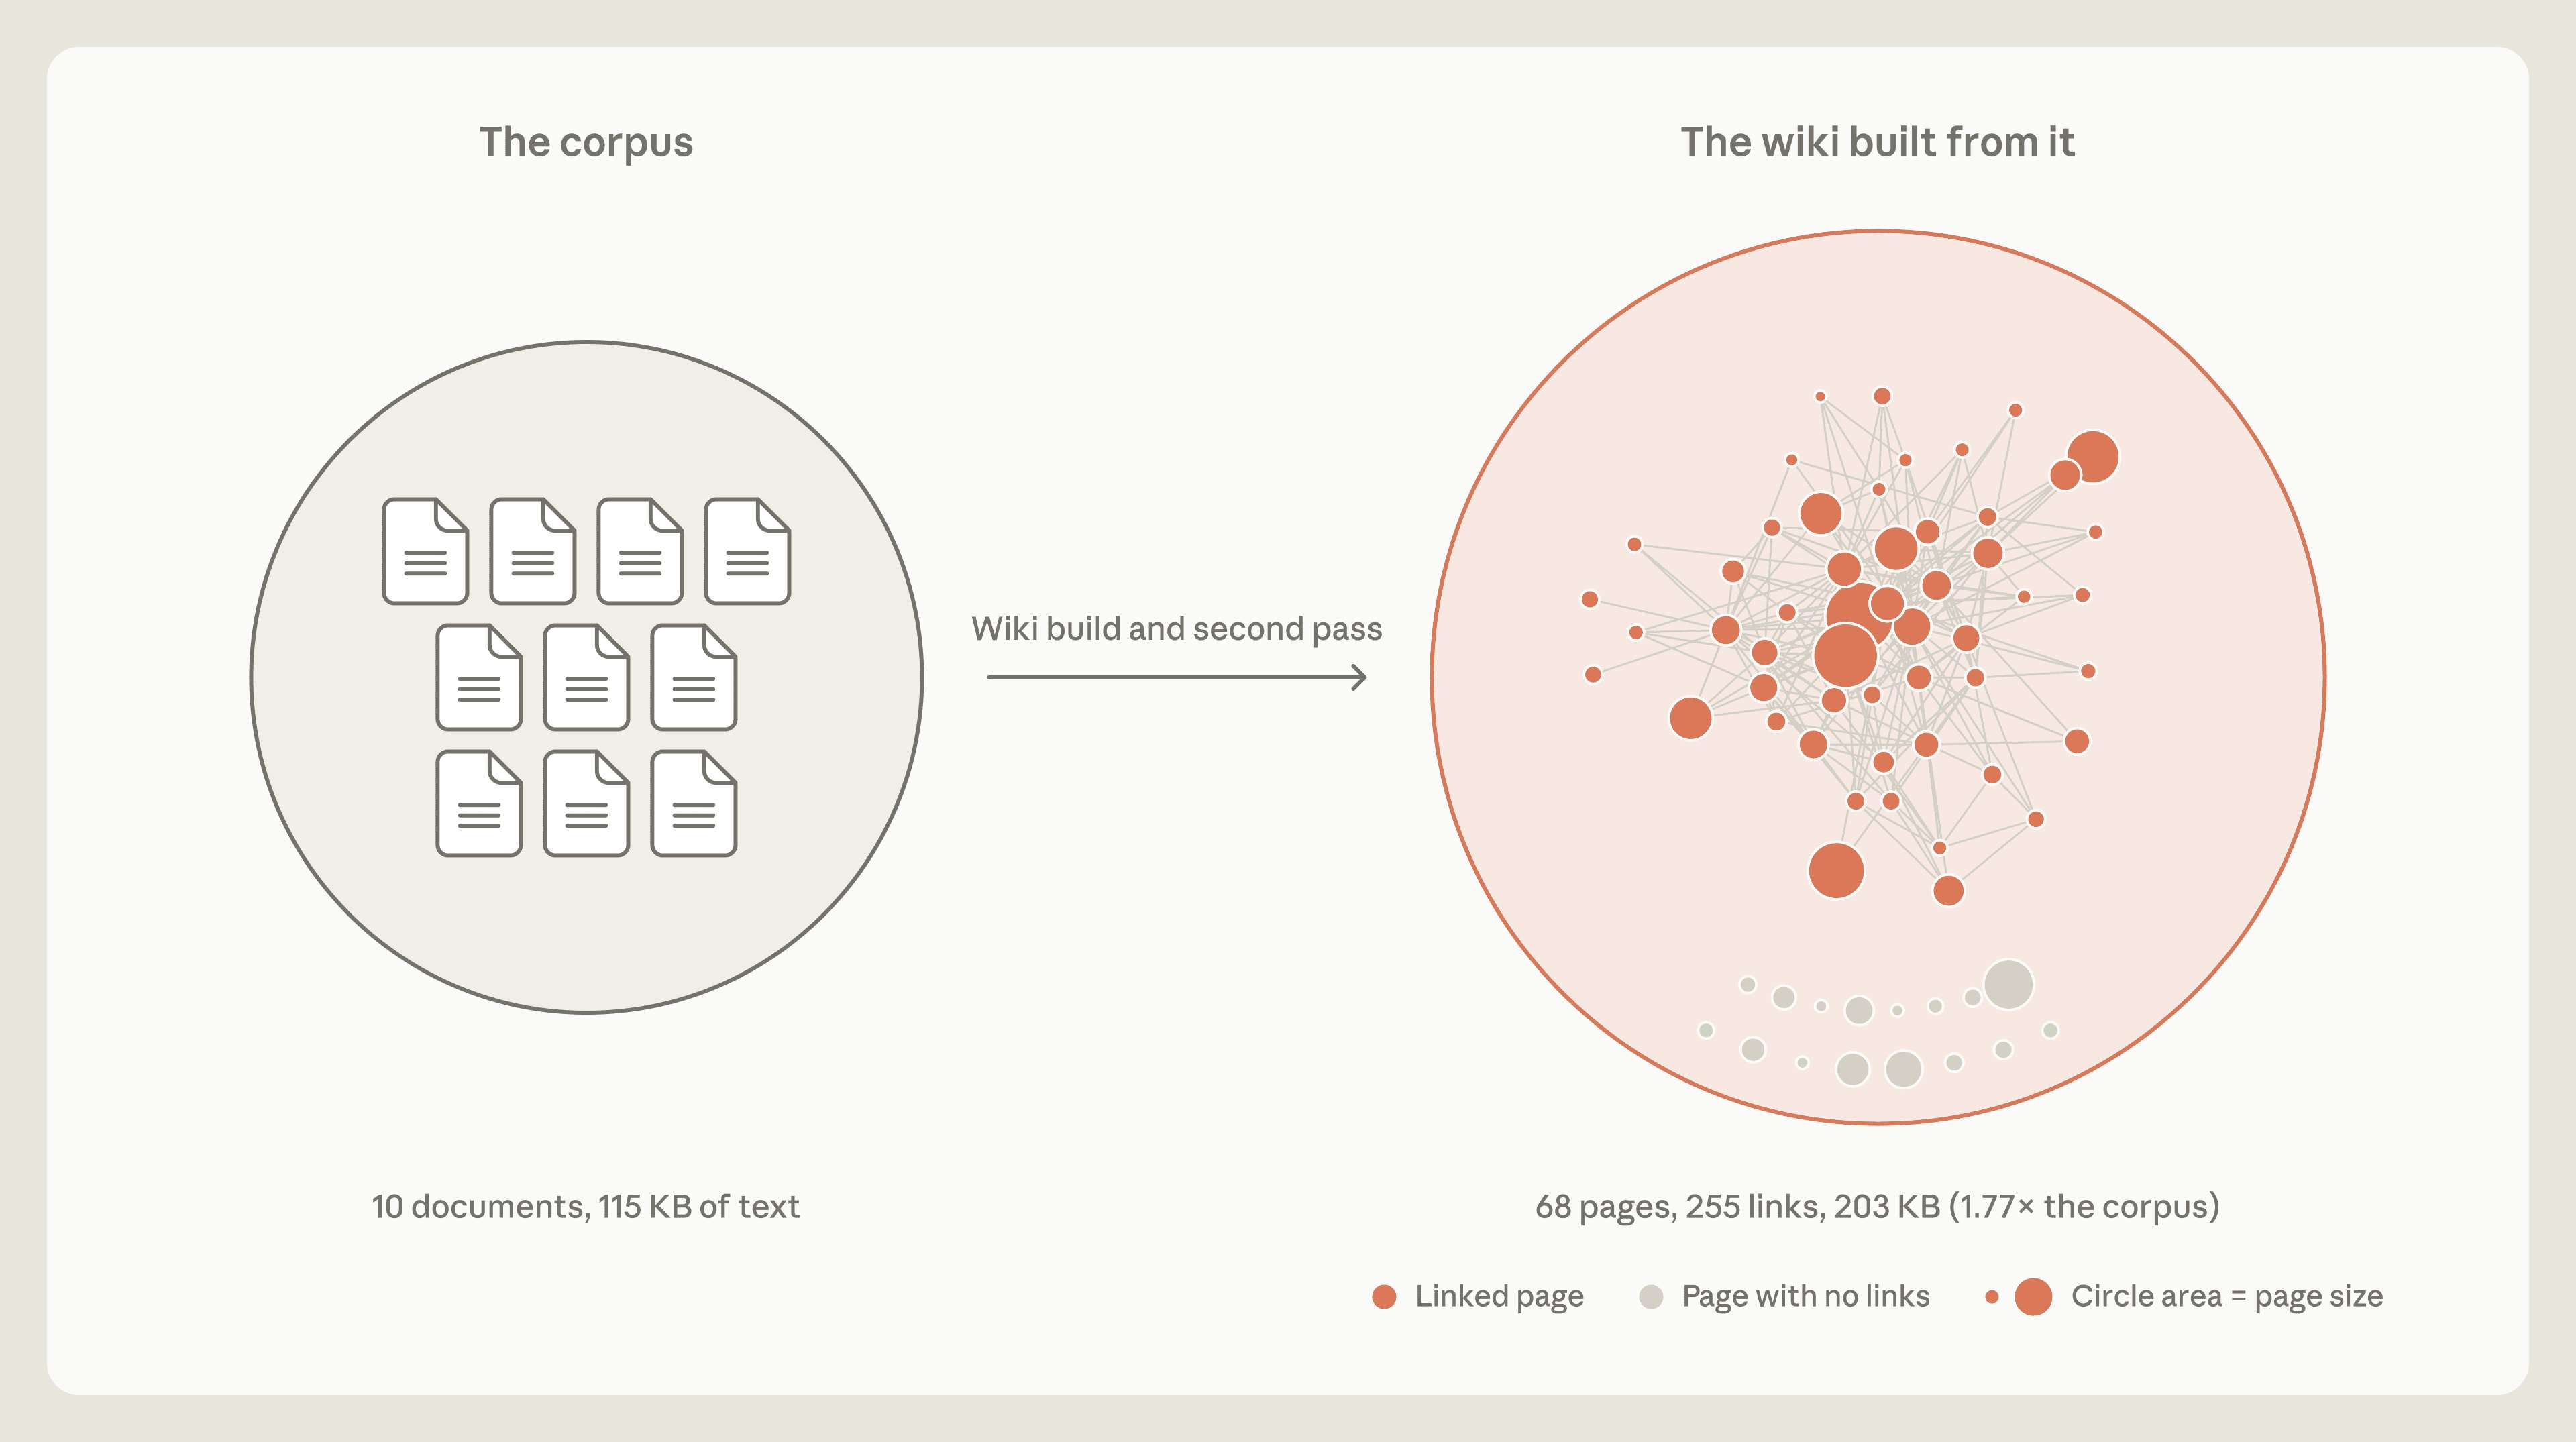
不过,Anthropic也发现了反例。如果构建指令缺乏约束,Wiki 也可能会出现过度膨胀、失去提炼作用的问题:在另一项 LAB 任务中,wiki(68 个页面、255 条链接,共 203 KB) 甚至增长得比文档本身(10 份文档,共 115 KB 文本)还大(图 12)。
高维提炼:上下文注入与精简索引
“做梦”还能把记忆层级的核心索引提炼并注入到最顶层,而Agent运行框架可以在每次会话开始时,预先把它们加载到 Claude 的上下文中(图 13)。这意味着 Claude 不必搜索这些内容,甚至不需要先意识到有东西值得去搜。
将记忆带入新会话,是上下文注入的一种形式,必须谨慎进行。注入的记忆会占用宝贵的 token,而一条错误笔记可能被带进每一次会话。加载一条笔记,也不保证 Claude 会遵照它行动:Claude Code 的文档提醒,指令文件越长,遵循程度就越低。因此,记忆层级的最上层必须保持相对精简;“做梦”在这里的许多工作,就是通过把部分细节下移到较低层级、同时留下链接,来维持这种精简。
如Claude Code 的自动记忆机制,也以同样方式保持注入层精简,每次会话只加载 MEMORY.md 的前 200 行或 25 KB作为高密度索引,让 Claude 了解自己已经记录了哪些信息,以及需要到哪里查找相关内容。
Thinking backward, looking forward
如何为Agent设计记忆系统,依然是当前 AI 领域极具挑战的开放课题。
即时记录虽然快速但会分散主任务的精力;而“做梦”虽然能够提炼知识、修正错误,但也需要付出额外的算力开销。将日志检索作为基础,结合 Wiki 表征与动态注入,是目前展现出极大潜力的解法。
正如丹麦哲学家 Kierkegaard 所言:“人生只能向后理解,但生活必须向前”。对于 AI Agent 而言,懂得“向后做梦”的反思机制,才能让它在未来的任务中走得更稳、更远。
看到这里我也恍然大悟了——原来我每天对着显示器屏幕发呆不叫摸鱼,叫 Dreaming(离线整理)啊!
感谢 Anthropic 给我的发呆找到了坚实的学术依据。以后导师或老板再问我在干嘛,我终于可以理直气壮地回答了: